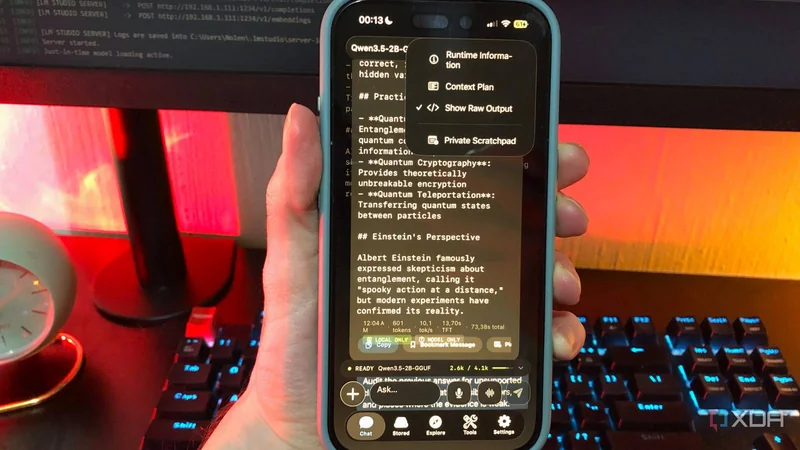
یک کاربر پس از یک ماه استفاده از مدلهای زبانی محلی (Local LLM) روی آیفون ۱۶ پایه، به این نتیجه رسیده است که حدود ۹۰ درصد پرسشهایی را که پیشتر به Claude و ChatGPT میفرستاد، میتواند بدون اتصال به کلاد و روی خود گوشی انجام دهد. به گفته او، بسیاری از کارهای روزمره مانند بازنویسی ایمیل یا توضیح یک واژه، نیازی به مدلهای پیشرفته در مرکز داده ندارند.
چرا حافظه گوشی تعیینکننده است؟
در اجرای مدل محلی، حافظه یکپارچه (Unified Memory) گوشی بیش از هر اپلیکیشن یا تنظیماتی اهمیت دارد. آیفون ۱۶ پایه با ۸ گیگابایت حافظه یکپارچه، در عمل امکان اجرای مدلهای ۲ تا ۴ میلیارد پارامتری را فراهم میکند؛ معمولاً به شکل کوانت (Quant) یا نسخه فشردهشده مدل. برای مثال، Q4 به معنای فشردهسازی تقریبی به ۴ بیت است.
حجم فایل کوانت اولین چیزی است که باید بررسی شود، چون تقریباً همان مقدار حافظهای است که مدل برای بارگذاری نیاز دارد. طول زمینه (Context Length) اما پیچیدهتر است؛ زیرا بخشی از فایل نیست و هر توکن (Token) آن، جدا از خود مدل، حافظه اضافه میگیرد. روی گوشی، طول زمینه واقعبینانه معمولاً بین ۴ تا ۸ هزار توکن تنظیم میشود.
مدلهایی که روی گوشی جواب میدهند
برای پرسشهای سریع، Qwen 3.5 2B با کوانت Q4_0 انتخاب شده که در پرامپتهای کوتاه به ۳۲ توکن بر ثانیه (tokens per second) میرسد و در پرامپتهای بلندتر بالای ۲۰ توکن بر ثانیه باقی میماند. Gemma 4 E2B نیز حدود ۲۶ توکن بر ثانیه سرعت دارد و به دلیل لحن گرمتر، برای گفتوگو و همچنین پردازش تصویر و یادداشت صوتی به کار میرود؛ چون قابلیت بینایی (Vision) و صدا (Audio) دارد.
برای کارهای جدیتر مانند یادگیری یا پژوهش، Qwen 3.5 4B با کوانت Q3_K_M توصیه شده است. این مدل سرعت را به حدود ۱۳ توکن بر ثانیه کاهش میدهد، اما در استدلال و پاسخهای ساختیافته بسیار دقیقتر عمل میکند. به گفته کاربر، تکیه بر یک مدل واحد توصیه نمیشود و چند مدل میتوانند طیف وسیعتری از وظایف را پوشش دهند.
اپلیکیشنهایی فراتر از یک چتباکس ساده
اجرای مدل محلی روی گوشی ساده است، اما پیدا کردن اپلیکیشنی که واقعاً جایگزین Claude یا ChatGPT باشد دشوارتر است. بیشتر اپلیکیشنهای آزمایششده فقط یک چتباکس و انتخابکننده مدل دارند و ابزارهای کاری لازم را ارائه نمیکنند.
Google AI Edge Gallery یکی از گزینههای محبوب است، اما فقط مدلهای قالب LiteRT گوگل را اجرا میکند و کاتالوگ آن کوچک است. در عوض، چندوجهیترین (Multimodal) تجربه را میدهد؛ چون AI Chat تصویر و صدا را میپذیرد و ابزارهای جداگانه Ask Image و Audio Scribe نیز دارد. مهارتهای عامل (Agent Skills) در این اپلیکیشن معادل ابزارها هستند و به مدل اجازه میدهند از ویکیپدیا اطلاعات بگیرد یا یادآور و رویداد تقویم بسازد. امکان تنظیم پرامپت سیستمی (System Prompt) برای هر ابزار نیز وجود دارد.
اپلیکیشن دیگر Noema است که یک ویژگی کلیدی دارد: پذیرش پیوست سند در چت. کاربر میتواند فایلهای PDF و EPUB را مستقیم به پروژه اضافه کند؛ چیزی شبیه Claude Projects روی گوشی. این اسناد بهصورت محلی ایندکس میشوند تا مدل بتواند در آنها جستوجو کند و منبع پاسخ را ذکر کند. جستوجوی وب اختیاری، حافظه پایدار (Persistent Memory) و ابزار پایتون (Python Tool) از دیگر قابلیتهای آن است. نقطه ضعف Noema این است که فقط برای iOS عرضه شده است.
کارهایی که همچنان به کلاد سپرده میشوند
استفاده آفلاین یکی از دلایل اصلی جذابیت مدلهای محلی موبایل است؛ بهویژه در شرایطی که قطع برق، دکلهای داده را هم از کار میاندازد. با این حال، برخی وظایف نمیتوانند منتظر بمانند و به اتصال نیاز دارند. همچنین مدل ۲ میلیارد پارامتری برای خواندن درست نتایج وب ضعیف است.
سرعت هم مهم است. احساس سریعبودن چتبات به زمان ظاهر شدن اولین کلمات بستگی دارد و پژوهش Nielsen Norman Group حد حفظ تمرکز را حدود یک ثانیه میداند؛ تأخیر شبکه و مکثهای پردازش روی موبایل بهراحتی این حد را از بین میبرند. بنابراین برای پژوهش در موضوعی ناآشنا، مانند کدنویسی، کلاد همچنان جلوتر است.
باتری نیز محدودیت دارد. یک بررسی نشان داده ۲۰ بار اجرای استنتاج (Inference) حدود ۱۰ درصد باتری آیفون ۱۶ پرو را مصرف میکند. همچنین گفتوگوهای محلی بهطور خودکار به دسکتاپ منتقل نمیشوند؛ اگر قرار است مکالمه در دستگاه دیگری ادامه یابد، باید به چتبات کلادی مراجعه کرد.
جایگاه تازه Claude و ChatGPT
Claude و ChatGPT حذف نمیشوند؛ تنها جایگاهشان تغییر کرده است. آنها دیگر انتخاب پیشفرض نیستند، بهویژه برای اسناد خصوصی که ترجیح میدهید روی دستگاه بمانند یا زمانی که به مغزی بدون اتصال نیاز دارید. پیشنهاد کاربر این است: پیش از دانلود هر اپلیکیشنی، یک هفته از تاریخچه چتبات خود را مرور کنید تا ببینید چه مقدار از آن واقعاً به کلاد نیاز داشته است.