استفاده از هوش مصنوعی مولد در کسبوکارها بهسرعت در حال گسترش است. بااینحال، ارسال اطلاعات محرمانه، اسناد مالی و سورسکدهای نرمافزاری به سرویسهای ابری خارجی (مانند OpenAI یا Anthropic) ریسکهای امنیتی و حقوقی شدیدی به همراه دارد. از سوی دیگر، ناپایداری پهنای باند اینترنت بینالملل و هزینههای دلاری سنگین توکنها، سازمانهای ایرانی را بهسمت استقرار سامانههای محلی (On-Premises AI) هدایت کرده است.
ابزارهای نوینی نظیر Ollama در کنار مدلهای متنباز فوقالعاده قدرتمند DeepSeek (بهویژه سریهای Coder و R1)، امکان اجرای روان مدلهای زبانی بزرگ (LLM) را درون شبکه سازمان فراهم آوردهاند. اما بزرگترین چالش تیمهای زیرساخت، پیادهسازی سختافزار استاندارد است. در ادامه، الزامات محاسباتی، معماری حافظه و نحوه کانفیگ سرورهای سازمانی HP برای هوش مصنوعی را بررسی میکنیم.
چرا استقرار محلی هوش مصنوعی برای سازمانها حیاتی است؟
- امنیت مطلق و حاکمیت داده: دادههای سازمان هرگز از بستر شبکه محلی خارج نمیشوند و ریسک نشت دیتا به صفر میرسد.
- استقلال کامل از اینترنت و فیلترینگ: سیستم حتی هنگام قطعی کامل ارتباط بینالملل، با سرعت شبکه محلی به کاربران پاسخ میدهد.
- توسعه بهینه RAG: اتصال مدل به پایگاه دادههای برداری سازمانی (مانند Qdrant) جهت ساخت چتباتهای اختصاصی پاسخگو بر مبنای اسناد داخلی.
- توجیه اقتصادی: تبدیل هزینههای متغیر اشتراک ابری به یک سرمایهگذاری مشخص و با بازگشت سرمایه روی زیرساخت فیزیکی.
برای بررسی مدلهای شاسی و استانداردهای طراحی زیرساخت پردازش موازی، راهنمای تخصصی سرور هوش مصنوعی معیارهای انتخاب را با جزئیات فنی ارزیابی کرده است.
انتخاب مدل و محاسبه دقیق VRAM موردنیاز
ابزار Ollama مدلها را بر پایه فرمت فشرده GGUF اجرا میکند. اگر حجم مدل بیشتر از ظرفیت حافظه کارت گرافیک (VRAM) باشد، بخش باقیمانده به رم سرور (CPU RAM) فرستاده میشود. این پدیده (CPU Offloading) به دلیل پهنای باند محدود گذرگاهها، سرعت تولید توکن را تا ۹۰ درصد کاهش میدهد.
برای محاسبه دقیق VRAM موردنیاز، از فرمول زیر استفاده کنید:
Total VRAM = Model Size + KV Cache + Driver Overhead
- حجم مدل (Model Size): حجم فایل مدل با توجه به نوع Quantization (مثلاً Q4_K_M).
- بافر کانتکست (KV Cache): فضای اختصاصی برای پردازش طول توالی متن (ورودی و خروجی) که با افزایش Context Window، به VRAM بیشتری نیاز دارد.
- سربار درایور (Driver Overhead): حافظه رزرو شده توسط درایور انویدیا و سیستمعامل (معمولاً ۱ تا ۲ گیگابایت).
راهنمای انتخاب مدل بر اساس سختافزار:
- مدلهای 7B/8B (کوانت ۴ بیتی): به ۶ تا ۸ گیگابایت VRAM نیاز دارند؛ مناسب برای وظایف اداری، خلاصهسازی و چتباتهای سبک.
- مدلهای 14B/16B: به ۱۶ تا ۱۸ گیگابایت VRAM نیاز دارند؛ نقطه تعادل عالی میان استدلال، کدنویسی و نیازهای پردازشی.
- مدلهای 32B/33B: به دستکم ۲۴ تا ۲۸ گیگابایت VRAM نیازمندند؛ گزینهای ایدهآل برای متنهای تخصصی حقوقی، تحلیل داده و استدلالهای پیچیده.
- مدلهای 70B: به بیش از ۴۸ گیگابایت VRAM نیاز دارند و مستلزم بهکارگیری چند کارت گرافیک بهصورت موازی (Multi-GPU) در یک سرور هستند.
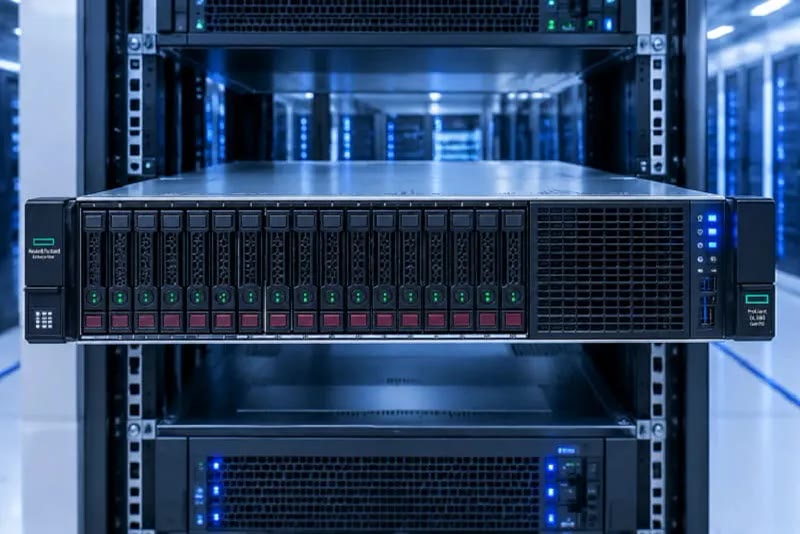
چرا سرور HPE ProLiant DL380 استاندارد دیتاسنترهاست؟
بهکارگیری سیستمهای دسکتاپ متفرقه برای بارهای کاری سنگین هوش مصنوعی به دلیل کارکرد مداوم در دمای بالا، به خرابی زودهنگام مادربورد و سیستم تغذیه منجر میشود. سرور دو یونیت (2U) HPE ProLiant DL380 به دلایل زیر استاندارد طلایی است:
- طراحی حرارتی مناسب شاسی 2U: فضای کافی برای تهویه پرفشار ۶ فن Redundant و نصب داکتهای هدایت هوا (GPU Air Baffle Kit).
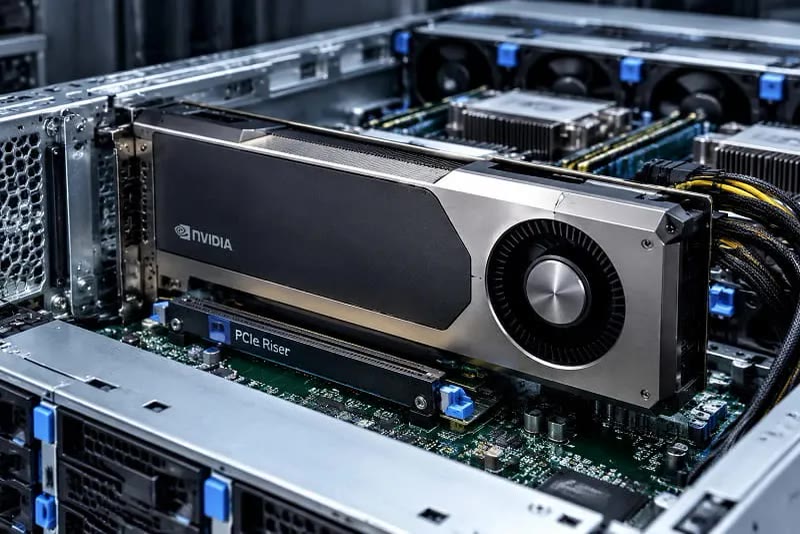
- پشتیبانی از کارتهای عریض: امکان نصب انواع رایزرهای x16 تمام ارتفاع برای کارتهای گرافیکی تک و دو اسلاته.
- تغذیه پایدار: پشتیبانی از دو پاور ماژولار پلاتینیوم یا تیتانیوم ۸۰۰ یا ۱۶۰۰ وات جهت پاسخ به جهشهای ناگهانی مصرف برق GPU.
برای مجموعههایی که تعادل میان بودجه، وفور قطعات در بازار و بازدهی پردازشی را مدنظر دارند، استعلام قیمت سرور hp dl380 g10 گزینهای اقتصادی و قابل ارتقا برای راهاندازی زیرساخت هوش مصنوعی سازمانی محسوب میشود.
انتخاب GPU: کارتهای سروری در برابر کارتهای تجاری
- کارتهای کلاس انترپرایز (NVIDIA T4 16GB / L4 24GB):خنکسازی آنها بهصورت Passive و از طریق جریان باد مستقیم فنهای سرور انجام میشود (بدون فن متحرک و خرابیپذیر). با توان مصرفی پایین (۷۰ تا ۷۵ وات)، کمترین فشار را بر سیستم برق وارد ساخته و درایورهای رسمی و باثباتی روی لینوکس دارند.
- کارتهای سری تجاری (GeForce RTX 3090 / 4090):با وجود توان پردازشی بالا و ۲۴ گیگابایت VRAM، ضخامت بالا (۲.۵ تا ۳ اسلات)، مصرف برق سنگین (۳۵۰ تا ۴۵۰ وات) و تداخل با منحنی فن سنسورهای iLO از چالشهای نصب آنها در رک محسوب میشود.
توصیه زیرساختی: برای راهاندازی یک سامانه پایدار ۲۴ ساعته سازمانی، ترکیب DL380 با یک یا دو کارت NVIDIA L4 یا T4 استانداردترین گزینه است.
الزامات CPU، RAM و معماری NUMA
- پردازنده (CPU): پردازندههای Intel Xeon Silver (نظیر 4210R) برای مدلهای تا 14B کافی هستند؛ اما برای پردازش همزمان درخواستهای سازمانی، سری Xeon Gold (مانند 6248R) گلوگاه پردازشی را برطرف میسازد.
- رم سرور: ظرفیت رم باید حداقل دو برابر اندازه مدل باشد. برای سناریوهای شرکتی، ۱۲۸ تا ۲۵۶ گیگابایت رم DDR4 ECC Reg با چیدمان چندکاناله متقارن پیشنهاد میگردد.
- ملاحظات NUMA: در سرورهای دو پردازندهای، پروسه پردازش مدل را با دستور numactl روی همان سوکت پردازندهای که کارت گرافیک به آن متصل است قفل کنید تا تاخیر تبادل داده بین سوکتها (UPI Bus) حذف شود:
numactl --cpunodebind=0 --membind=0 ollama serve
معماری ذخیرهسازی دادههای برداری (RAG) و پایگاه دانش سازمانی
یکی از ارکان کلیدی در بهینهسازی عملکرد مدلهای هوش مصنوعی سازمانی، پیادهسازی سیستمهای RAG (Retrieval-Augmented Generation) است. در این معماری، مدل زبانی به یک پایگاه داده برداری (Vector Database) متصل میشود تا پیش از پاسخگویی به کاربر، اسناد داخلی، آییننامهها و سابقههای مربوطه را جستجو کرده و دقیقترین مستندات را به عنوان زمینه (Context) به مدل تزریق کند.
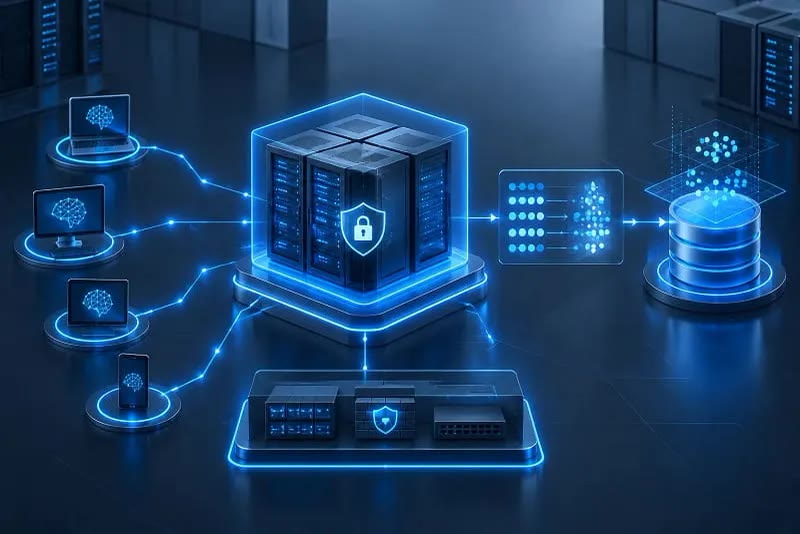
- نقش درایوهای NVMe Enterprise: جستجوی شباهت کسینوسی در میان میلیونها بردار اطلاعاتی نیازمند خواندن تصادفی فوقالعاده سریع از روی دیسک است. استفاده از درایوهای NVMe سازمانی (مانند مدلهای Mixed-Use با طول عمر بالا) به جای هیسکهای مکانیکی قدیمی، زمان پاسخگویی موتور جستجوی برداری را به حداقل میرساند.
- کنترلر رید پیشرفته: بهکارگیری کنترلرهای رید سری P در سرورهای HP مجهز به حافظه کَش اختصاصی محافظتشده با باتری (FBWC)، تضمین میکند که تراکنشهای ثبت پایگاه داده و لاگهای سازمانی حتی در صورت نوسانات ناگهانی برق دچار corruption یا از دست رفتن اطلاعات نشوند.
- ایزولهسازی شبکه و کش پنهان: توصیه میشود دیتابیسهای برداری و فایلهای اصلی مدلهای Ollama روی یک پارتیشن مجزا با فایلسیستمهای بهینهلینوکسی (مانند X4 یا ZFS) مدیریت شوند تا قطعیهای احتمالی سرویس، آسیبی به ساختار ایندکسها وارد نکند.
کانفیگ پیشنهادی سرور HPE DL380 Gen10 برای سازمانها
| مؤلفه |
مشخصات قطعه در DL380 Gen10 |
مزیت در پردازش هوش مصنوعی |
| شاسی |
HPE DL380 Gen10 8SFF 2U |
خنکسازی کارآمد، پشتیبانی از رایزر x16 |
| پردازنده |
۲ عدد Intel Xeon Gold 6248R |
پردازش سریع صف درخواستها و عدم افت فرکانس |
| رم |
۱۲۸ تا ۲۵۶ گیگابایت DDR4 ECC Reg |
بافرینگ مدل و پایگاههای برداری RAG |
| گرافیک |
۱ یا ۲ عدد NVIDIA L4 24GB یا T4 16GB |
معماری دیتاسنتری، بدون فن و پایدار |
| دیسک |
۲ عدد SSD NVMe Enterprise (Raid 1) |
لود چندثانیهای مدلهای سنگین روی رم |
| منبع تغذیه |
۲ عدد پاور پلاتینیوم 800W یا 1600W |
افزونگی کامل خطوط تغذیه الکتریکی |
امنیت، مانیتورینگ و پایداری بلندمدت
- سرویس هوش مصنوعی را هرگز مستقیماً روی پورت خام اینترنت یا شبکه عمومی رها نکنید؛ آن را پشت یک Reverse Proxy (مانند Nginx) به همراه پروتکل HTTPS و احراز هویت قرار دهید.
- از طریق کنسول iLO 5 وضعیت سلامت سختافزار، لرزش خطوط برق و دمای کارتهای PCIe را مرتباً رصد کنید.
- فریمورهای بایوس، درگاههای PCIe و کنترلرها را از طریق بستههای رسمی SPP آپدیت نگه دارید تا سازگاری کامل قطعات سختافزاری حفظ شود.
جمعبندی
راهاندازی مدلهای متنباز نظیر DeepSeek بر بستر Ollama در شبکه سازمانی، امنترین و سریعترین راهکار پیادهسازی هوش مصنوعی درونسازمانی است. با گزینش سرورهای استاندارد رکمونت نظیر HPE ProLiant DL380 و انتخاب اصولی کارت گرافیک و سیستم ذخیرهسازی برداری، پایداری عملیاتی تضمین میشود.
پیکربندی تخصصی سختافزاری، تطبیق رایزرها و تأمین قطعات اورجینال نیازمند تجربه فنی در حوزه سرور است. برای مشاوره در زمینه کانفیگ و استعلام سرورهای استاندارد هوش مصنوعی، میتوانید به متخصصان ولکان سرور ایرانیان به عنوان مرجع تخصصی تأمین سرورهای اچپی و قطعات انترپرایز مراجعه نمایید.