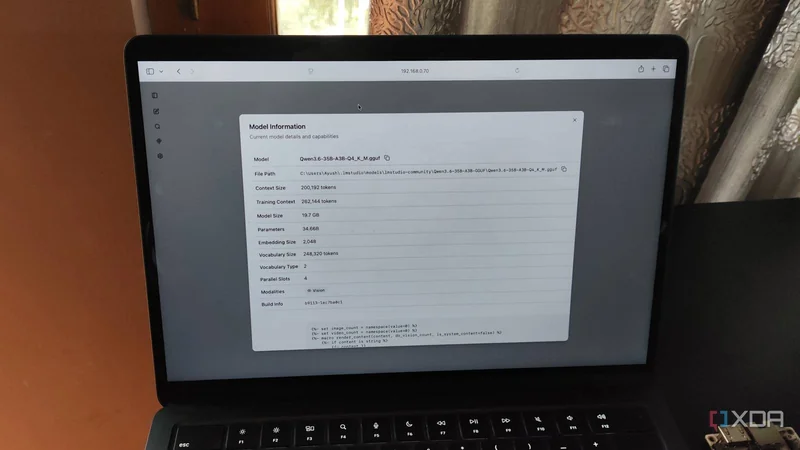
اجرای محلی مدلهای زبانی بزرگ (Large Language Models) تا پیش از فراگیر شدن معماری ترکیب خبرگان (Mixture-of-Experts یا به اختصار MoE)، به یک معادله ساده اما محدودکننده گره خورده بود: هرچه مدل بزرگتر، حافظه گرافیکی (VRAM) بیشتری لازم است. اما این معماری جدید، تعریف «مدلی که روی کارت گرافیک من جا میشود» را دگرگون کرده است.
مدلهای متراکم و گلوگاه حافظه گرافیکی
در مدلهای زبانی متعارف با معماری متراکم (Dense)، هنگام پردازش هر توکن، تمام پارامترهای شبکه فعال هستند. به همین دلیل کارت گرافیک باید حافظه کافی برای جای دادن کل مدل داشته باشد. اگر کاربری کارت گرافیک ضعیفی داشته باشد، میتواند برخی لایهها را به حافظه سیستم (System Memory) منتقل کند، اما در این حالت موتور استنتاج (Inference Engine) ناچار است دادهها را بهطور مداوم میان حافظه و گذرگاه PCIe جابهجا کند و سرعت تولید توکن به شدت افت میکند.
راهحل جایگزین، استفاده از کوانتیزاسیون (Quantization) با دقت پایین است، اما این کار توان محاسباتی مدل را بهطور محسوسی کاهش میدهد. بر پایه برآوردهای رایج، یک مدل ۷ میلیارد پارامتری در کوانتیزاسیون Q4 به حدود ۴ تا ۵.۵ گیگابایت حافظه گرافیکی نیاز دارد که برای کارتی با ۸ گیگابایت حافظه کافی است. روی کارتهای ۱۲ گیگابایتی میتوان تا مدلهای ۱۲ میلیارد پارامتری و حتی نمونههای ۱۵ میلیاردی در Q4 پیش رفت، اما فراتر از آستانه ۱۸ میلیارد پارامتر، کارت گرافیک متوسط معمولاً از عهده چنین مدلهایی برنمیآید.
معماری MoE چگونه محدودیت VRAM را دور میزند
مدلهای MoE ساختاری متفاوت دارند. به جای یک شبکه پیشخور بزرگ (Feed-Forward Network) در هر بلوک، این مدلها چندین شبکه موازی به نام «خبره» (Expert) دارند و به جای فعالسازی همه پارامترها برای هر توکن، یک سازوکار مسیریابی (Routing Mechanism) هر توکن را به خبره مشخصی اختصاص میدهد. در نتیجه تنها گروهی محدود از خبرهها در محاسبه هر توکن دخیل هستند و بقیه بیکار میمانند.
همین ویژگی اجازه میدهد بخشی از مدل روی حافظه گرافیکی و بخشی دیگر روی حافظه سیستم قرار گیرد، بدون آنکه افت شدید سرعت رخ دهد. در چنین چیدمانی میتوان سازوکار مسیریابی، وزنهای توجه (Attention Weights)، تعبیهها (Embeddings) و خبرههای فعال را در VRAM نگه داشت و سایر لایههای خبره را در حافظه سیستم مستقر کرد. البته مجموع حافظه گرافیکی و رم باید برای همه پارامترهای مدل کافی باشد، اما از آنجا که نرخ تولید توکن در این حالت تقسیمشده چندان آسیب نمیبیند، میتوان مدلهای بسیار حجیمی را آزمایش کرد که در معماری متراکم سنتی با سرعتی بسیار کند اجرا میشدند.
اعداد واقعی: از RTX 3080 Ti تا GTX 1080
در عمل، یک کارت RTX 3080 Ti با ۱۲ گیگابایت حافظه گرافیکی در کنار ۳۲ گیگابایت رم، مدل Qwen3.6-35B-A3B را با تنظیم پرچم --no-cpu-moe روی ۲۵ لایه در چارچوب llama.cpp، با سرعتی در حدود ۲۴ توکن بر ثانیه اجرا میکند؛ رقمی قابل توجه برای مدلی ۳۵ میلیارد پارامتری که در حالت معمول به کارتهای گرانقیمت نیاز دارد.
نمونه چشمگیرتر، کارت GTX 1080 با ۸ گیگابایت حافظه گرافیکی است که نه تنها از نظر حافظه محدود است، بلکه هستههای تنسور (Tensor Cores) نیز ندارد. با این حال، روی یک گره Proxmox مجهز به حدود ۳۲ گیگابایت حافظه DDR4، همین کارت مدل Gemma-4-26B-A4B را با سرعت حدود ۱۴ توکن بر ثانیه اجرا میکند که برای کارتی از نسل پاسکال (Pascal) عددی غیرمنتظره است.
کاربرد در ابزارهای بهرهوری و آزمایشگاه خانگی
این مدلها صرفاً یک آزمایش فنی نیستند و میتوانند موتور محرک مجموعهای از ابزارهای بهرهوری باشند:
- استفاده از نمونه Qwen3.6-35B-A3B روی RTX 3080 Ti به عنوان جایگزین Copilot در VS Code
- ترکیب آن با Perplexica و Vane برای عیبیابی پروژههای ناکام
- اتکای ابزارهای خودمیزبان مانند Open Notebook، Blinko و Paperless-GPT به مدل Gemma-4-26B-A4B روی GTX 1080 برای ارائه قابلیتهای هوش مصنوعی
در مجموع، معماری MoE نشان میدهد که معیارهای سنتی سنجش توان سختافزار برای اجرای مدلهای زبانی دیگر پاسخگوی نیاز کاربران نیست و توصیههای رایج خرید کارت گرافیک باید بازنگری شوند.