اجرای مدلهای زبانی بزرگ بهصورت محلی (Local LLM) تا همین اواخر با یک محدودیت آشنا همراه بود: مدلهای محلی خوب هستند، اما در سطح مدلهای مرزی (Frontier Models) نیستند. مدلهایی که همه معیارهای سنجش را روی آنها تنظیم میکنند، در مراکز داده و پشت یک رابط برنامهنویسی (API) زندگی میکنند و بر اساس توکن اجاره داده میشوند. اما انتشار وزنهای مدل GLM-5.3 توسط شرکت Z.ai این معادله را تغییر داد؛ مدلی با ۷۴۴ میلیارد پارامتر از نوع مخلوطخبرگان (Mixture-of-Experts) که بر اساس اعداد خودِ Z.ai، با سنگینوزنهای ابری رقابت میکند.
نسخه کامل این مدل حدود ۱.۵ ترابایت حجم دارد و چیزی نیست که بهسادگی روی یک ایستگاه کاری دانلود شود. با این حال، ترکیب کوانت داینامیک ۲ بیتی (2-bit Dynamic Quant) از Unsloth و ابزار llama.cpp باعث شد این مدل روی یک ورکاستیشن زیر میز کاربر اجرا شود؛ تجربهای که به گفته او بدون دردسر نبود و یک تنظیم خاص تقریباً پیش از شروع، همه چیز را متوقف کرد.
چرا یک مدل ۷۴۴ میلیارد پارامتری روی ورکاستیشن جا میشود؟
کلید ماجرا معماری مخلوطخبرگان است. از میان ۷۴۴ میلیارد پارامتر GLM-5.3، برای تولید هر توکن تنها ۴۰ میلیارد پارامتر فعال میشوند. میتوان آن را به کتابخانهای عظیم تشبیه کرد که هر پرسش فقط به چند قفسه از آن نیاز دارد؛ با این حال باید کل کتابخانه ذخیره شود، اما یکباره خوانده نمیشود.
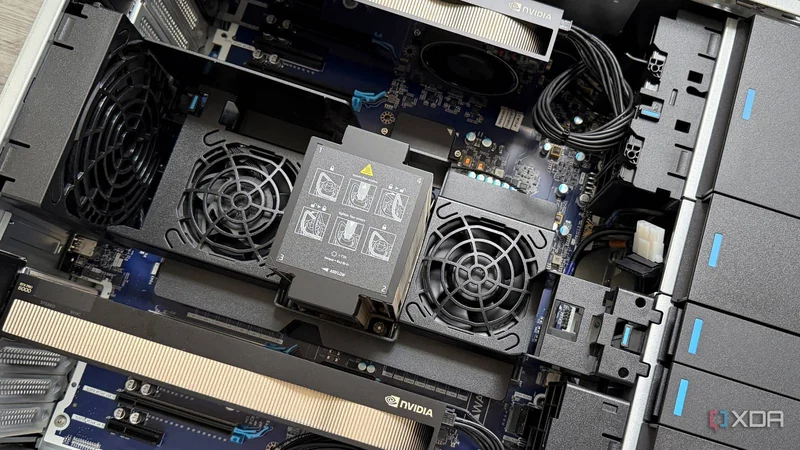
دستگاه آزمایش این کاربر یک ورکاستیشن HP Z8 Fury G6i با پردازنده Xeon 696X، دو کارت گرافیک NVIDIA RTX PRO 6000 Blackwell Max-Q با ۹۶ گیگابایت حافظه گرافیکی (VRAM) روی هر کارت و ۱۲۸ گیگابایت حافظه رم سیستم بود. مجموع ۱۹۲ گیگابایت VRAM برای یک دسکتاپ عددی خیرهکننده است، اما همچنان کافی نیست؛ بنابراین خبرگانی (Experts) که در کارتهای گرافیک جا نمیشوند، در حافظه رم سیستم مستقر میشوند.
انتخاب کوانت ۲ بیتی؛ نقطه تعادل در ۳۲۰ گیگابایت حافظه
با احتساب حافظه کارتهای گرافیک و رم سیستم، حدود ۳۲۰ گیگابایت فضای قابل استفاده در اختیار است. Unsloth طیف گستردهای از کوانتهای GLM-5.3 را منتشر کرده و اعداد، تعیینکننده همه چیز هستند:
- UD-IQ1_S (یک بیتی): حجم فایل ۲۱۶.۷ گیگابایت — در ۳۲۰ گیگابایت جا میشود.
- UD-IQ2_M (دو بیتی): حجم فایل ۲۳۸.۶ گیگابایت — جا میشود، با فضای مازاد.
- UD-Q3_K_XL (سه بیتی): حجم فایل ۳۴۳.۰ گیگابایت — جا نمیشود.
انتخاب نهایی، نسخه UD-IQ2_M بود. گرچه کوانت ۲ بیتی در نگاه اول باید یک مدل مرزی را به خمیری بیکیفیت تبدیل کند، کوانتهای داینامیک Unsloth لایههای مهم را با دقت بالاتری نگه میدارند و آزمونهای خود این شرکت، میزان توافق توکن نخست (Top-1 Agreement) نسخه IQ2_M با مدل کامل را ۷۸.۵۳ درصد اعلام کرده است.
اجرای مدل در WSL2 بهجای لینوکس خام
این سیستم ویندوز ۱۱ را اجرا میکند و به گفته کاربر، زیرسیستم WSL2 بهقدری خوب عمل میکند که نیازی به نصب دوگانه (Dual-Boot) نیست؛ بنابراین کل فرایند در همان محیط انجام شد. درایور ویندوز (نسخه ۶۱۶.۹۲) هر دو کارت گرافیک را بهصورت عبوری (Passthrough) در اختیار WSL قرار میدهد و در این محیط تنها به جعبهابزار CUDA نیاز است، نه درایور لینوکس.
تنها تنظیمی که نمیتوان از آن گذشت، محدودیت حافظه WSL است؛ زیرا بهصورت پیشفرض فقط نیمی از رم سیستم را دریافت میکند. این مقدار در فایل .wslconfig به ۱۱۶ گیگابایت افزایش یافت، چون ۶۴ گیگابایت در میانه بارگذاری مدل تمام میشد.
تنظیمی در llama.cpp که بارگذاری مدل را متوقف کرد
هر دو کارت گرافیک برای مدل جا داشتند، اما llama.cpp آن را بهشکل نامناسبی تقسیم کرد. نخستین تلاش، حدود شش دقیقه کل ۲۳۹ گیگابایت را از دیسک خواند و سپس با خطای کمبود حافظه در تخصیص ۱۱۳۱۸۶.۵۹ مگابایت روی دستگاه شماره یک شکست خورد؛ یعنی llama.cpp تلاش کرده بود حدود ۱۱۰ گیگابایت را روی کارتی با تنها ۹۳ گیگابایت فضای آزاد قرار دهد. مشکل، بزرگی مدل نبود؛ تقسیمبندی نادرست بود.
چرا پرچم --n-cpu-moe کارت دوم را اشباع کرد
پرچم کلیدی که این راهاندازی را ممکن میکند --n-cpu-moe است؛ این گزینه به llama.cpp میگوید خبرگان مربوط به N لایه نخست را در رم سیستم نگه دارد و در نتیجه آن لایهها بهصورت پوستههای سبک روی کارت گرافیک باقی میمانند. مقدار این پرچم روی ۲۰ تنظیم شده بود.
مشکل اینجا بود که llama.cpp بهصورت پیشفرض لایهها را بر اساس تعداد، بهطور مساوی میان کارتها تقسیم میکند. کارت صفر نیمه نخست را گرفت که شامل همان ۲۰ لایه سبک بود و کارت یک، نیمه دوم یعنی ۳۹ لایه با خبرگان کامل را دریافت کرد. نتیجه، کارتی بود که بیدغدغه کار میکرد و کارتی که زیر بار سنگین مانده بود. بدتر آنکه کارت دوم نمایشگرها را نیز راه میاندازد و ویندوز پیش از بارگذاری مدل حدود ۲.۲ گیگابایت از آن را اشغال کرده بود.
تقسیم دستی لایهها
راهحل، پایان دادن به حدسزنی llama.cpp بود. با افزودن پرچم --tensor-split 64,36 لایههای بیشتری به کارت صفر سپرده شد و با تغییر مقدار --n-cpu-moe به ۲۲، دو لایه خبره دیگر نیز به رم منتقل شد. بارگذاری بعدی موفق بود و اوج مصرف به ۹۳.۹ گیگابایت روی کارت صفر و ۸۰.۱ گیگابایت روی کارت یک رسید.
عملکرد اندازهگیریشده روی دو کارت RTX PRO 6000
پس از بارگذاری مدل، آزمونی شامل سنجش سرعت، بازیابی حافظه بلندمدت، فراخوانی ابزار (Tool Calling) و چند پرامپت واقعی اجرا شد. همه اجراها با بیلد e937b17a2 از llama.cpp، بافت (Context) ۶۴ هزار توکنی و حافظه نهان KV از نوع q4_1 انجام شد:
- سرعت تولید: ۱۱.۳ توکن بر ثانیه
- پردازش پرامپت (پرامپت حدود ۲ هزار توکنی): ۸۲.۷ توکن بر ثانیه
- زمان تا نخستین توکن با پرامپت ۸۱۸۴ توکنی: ۹۶.۹ ثانیه
- زمان تا نخستین توکن با پرامپت ۳۲۹۸۴ توکنی: ۳۹۳.۹ ثانیه
- بازیابی کد پنهان در ۸ هزار و ۳۲ هزار توکن: هر دو یافت شد
- فراخوانی ابزار: موفق
سرعت تولید حتی در پاسخهای ۱۲ هزار توکنی بین ۱۲.۰ تا ۱۲.۲ توکن بر ثانیه پایدار ماند و افت نکرد؛ سرعتی که بهراحتی از سرعت خواندن انسان بیشتر است. مدل ابزارها را درست فراخوانی کرد و کدی را یافت که در عمق ۶۰ درصدی یک گزارش ۳۳ هزار توکنی پنهان شده بود.
هزینه واقعی: پردازش پرامپتهای طولانی
دقیقاً همانجایی که خبرگان مستقر در رم سیستم ضربه میزنند، پردازش پرامپت است. این فرایند مستقل از طول پرامپت با سرعت حدود ۸۴ توکن بر ثانیه انجام میشود؛ یعنی یک پرامپت ۸ هزار توکنی حدود یکونیم دقیقه و یک پرامپت ۳۲ هزار توکنی بیش از ششونیم دقیقه انتظار پیش از ظاهر شدن نخستین کلمه به همراه دارد. با این آهنگ، یک پرامپت ۱۰۰ هزار توکنی تقریباً ۲۰ دقیقه زمان میبرد. برای گفتوگوی معمولی این مقدار قابل قبول است، اما برای یک عامل هوشمند (Agent) که در حال پردازش یک پایگاه کد بزرگ است، به معنای انتظار طولانی مقابل ترمینال خواهد بود.
استدلال عمیق؛ چشمگیر اما گران
GLM-5.3 پیش از پاسخ دادن استدلال میکند و این قابلیت را نمیتوان خاموش کرد؛ تنها میتوان سطح تلاش را روی کم، زیاد یا حداکثر تنظیم کرد. در آزمون کیفیت با سطح تلاش زیاد و سقف ۱۲ هزار توکن برای هر پاسخ، نتیجه جالبترین بخش آزمایش بود: درخواست ساخت یک بازی مار کامل در قالب یک فایل HTML، مدل را وادار کرد ۱۰۰۰ ثانیه فکر کند و ۴۴۸۳۲ کاراکتر استدلال تولید کند، اما سقف توکن تمام شد و هیچ خطی از کد بازی نوشته نشد.
البته مدل خراب نیست؛ پرامپت برنامهنویسی دیگر، یعنی ساخت یک محدودکننده نرخ (Rate Limiter) امن برای چندرشتهای همراه با مجموعه آزمون کامل، در هشت دقیقه با موفقیت به پایان رسید. اما با سرعت ۱۲ توکن بر ثانیه، بودجه استدلالی که در فضای ابری آنی به نظر میرسد، به ۱۷ دقیقه تماشای برنامهریزی مدل تبدیل میشود. تلاش دوم با سقف ۳۲ هزار توکن پس از ۴۷ دقیقه در میانه بازی تمام شد؛ با صفحه عنوانی زیبا اما بدون بازی قابل اجرا. در سطح تلاش کم، نسخهای ساده اما کارآمد در چهارونیم دقیقه نوشته شد، در حالی که مدل Claude Sonnet 5.5 از Anthropic با سطح تلاش زیاد، نسخهای کارآمد را در کمتر از یک دقیقه تولید کرد.
مدل، گلوگاه خودش را پیش از سنجش تشخیص داد
در یکی از پرامپتهای استدلالی، همین پیکربندی دقیق توصیف شد و سقف نظری سرعت پرسیده شد. GLM-5.3 محاسبه کرد که هر توکن به خواندن حدود ۱۵.۵ گیگابایت وزن نیاز دارد، سقف را بین ۳۹ تا ۵۰ توکن بر ثانیه تخمین زد و سپس در یک خط اصل ماجرا را بیان کرد: لایه رم حدود یکسوم مدل را در خود جای داده، اما حدود ۷۷ درصد زمان تولید توکن را مصرف میکند. مدل پیشبینی کرد که در عمل سرعت ۱۵ تا ۲۵ توکن بر ثانیه مشاهده خواهد شد؛ عددی که در سنجش واقعی ۱۱.۳ توکن بر ثانیه از آب درآمد.
جمعبندی؛ مرزها نزدیکتر از همیشه
اینکه چنین مدلی اصلاً اجرا میشود، دستاورد قابل توجهی است. تا چندی پیش مدلهای محلی تنها برای مرتبسازی فایلها یا گفتوگویی ساده به کار میآمدند و هر مدلی در این رده وزنی، به اجاره کارتهای گرافیک مرکز داده نیاز داشت. اکنون ماجرا به دو کارت گرافیک ورکاستیشن، یک دانلود کوانتشده، یک پرچم سرسخت در llama.cpp و یک شب زمان خلاصه میشود. البته این پیکربندی حدود ۶۵ هزار دلار هزینه دارد و هنوز جایگزین ابر نیست و برای بیشتر کاربران قابل تهیه نیست؛ اما همین چند سال پیش، اجرای هر مدل زبانی به سختافزاری بهمراتب سنگینتر نیاز داشت.