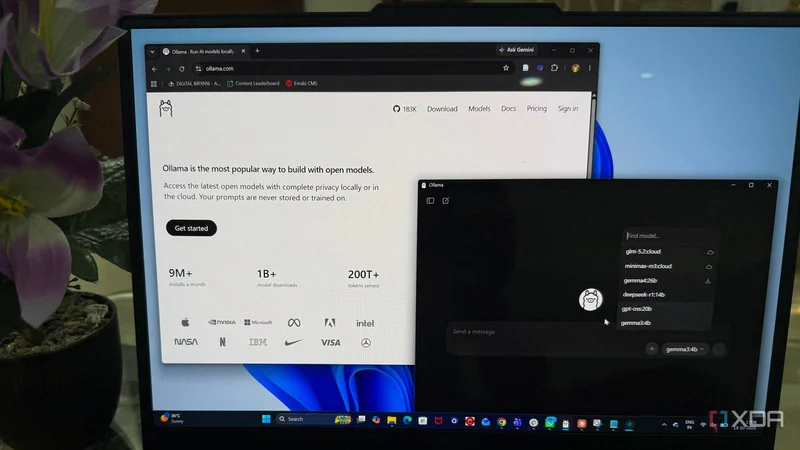
اجرای هوش مصنوعی بهصورت محلی (Local AI) میتواند حریم خصوصی و کنترل بیشتری در اختیار کاربر قرار دهد، اما انتخاب نرمافزار مناسب بیش از آنچه در ابتدا تصور میشود اهمیت دارد. Ollama یکی از سادهترین راهها برای شروع کار با مدلهای زبانی محلی است؛ ابزاری که به کاربر اجازه میدهد بدون پیکربندی پیچیده، مدلها را دانلود و اجرا کند. با این حال، وقتی نیازها پیشرفتهتر میشوند، ممکن است محدودیتهای آن آشکار شود و کاربر به فکر جایگزینی با موتور استنتاجی (Inference Engine) مانند llama.cpp بیفتد.
Ollama؛ سادهترین نقطه ورود به هوش مصنوعی محلی
در نخستین تجربهها، Ollama فرایند راهاندازی هوش مصنوعی محلی را بهطرز چشمگیری ساده میکند. کاربر نیازی ندارد ساعتها برای پیکربندی یک موتور استنتاج وقت بگذارد یا نحوه کار اجزای مختلف را کشف کند. کافی است Ollama را نصب کند، یک مدل را دانلود کند و از طریق ترمینال با آن گفتوگو کند. همین مقدار برای اجرای نخستین مدل زبانی بزرگ (LLM) محلی کافی است.
مزیت اصلی Ollama در همین سادگی نهفته است. اگر کاربر بخواهد مدل دیگری را آزمایش کند، میتواند آن را با یک فرمان ساده دانلود کرده و تقریباً بلافاصله به کار بگیرد. نیازی به مدیریت دستی همه بخشهای فرایند پیش از مشاهده تواناییهای مدل وجود ندارد.
Ollama به گفتوگو در ترمینال محدود نمیشود. این ابزار بهعنوان یک سرویس پسزمینه (Background Service) اجرا میشود و یک API در اختیار برنامههای دیگر قرار میدهد. به این ترتیب، اتصال مدلهای محلی به ابزارهای مختلف بدون ساخت یک مجموعه هوش مصنوعی از صفر آسان میشود.
- نصب سریع و اجرای مدل از طریق ترمینال
- دانلود مدل جدید با یک فرمان ساده
- اجرا بهعنوان سرویس پسزمینه و ارائه API برای اتصال به ابزارهای دیگر
- امکان آزمایش و مقایسه پاسخ مدلهای مختلف
به همین دلیل، Ollama همچنان یک نقطه ورود عالی برای کسانی است که میخواهند هوش مصنوعی را بهصورت محلی اجرا کنند. این ابزار بخش زیادی از پیچیدگی اولیه را حذف میکند و به کاربر اجازه میدهد بهجای درگیری با پیکربندی، احتمالات را کشف کند.
زمانی که Ollama از مسیر نیازها عقب میماند
Ollama اجرای هوش مصنوعی محلی را آسان میکند، اما بهمرور این پرسش مطرح میشود که آیا بهترین عملکرد از سختافزار گرفته میشود یا نه. اجرای یک مدل از طریق موتورهای استنتاج مختلف میتواند نتایج متفاوتی به همراه داشته باشد و لایه انتزاعی (Abstraction Layer) Ollama ممکن است در مقایسه با اجرای مستقیم llama.cpp سربار (Overhead) ایجاد کند. این موضوع لزوماً به معنای کندتر بودن همیشگی نیست، اما کنجکاوی درباره آنچه از دست میرود را برمیانگیزد.
پنجره زمینه (Context Window) پیشفرض نیز مسئله دیگری است. Ollama معمولاً از طول زمینه ۴۰۹۶ توکن استفاده میکند، مگر اینکه تنظیمات دیگری اعمال شود. این مقدار برای گفتوگوهای ساده مناسب است، اما هنگام تحلیل اسناد طولانی یا کار با ابزارهایی که به زمینه بیشتری نیاز دارند، محدودکننده میشود. بخش آزاردهنده این است که وقتی Ollama پشت یک رابط کاربری قرار میگیرد، این محدودیت همیشه آشکار نیست و کاربر باید پیکربندی سرور را با دقت بیشتری بررسی کند.
ذخیرهسازی مدلها در Ollama نیز تغییر موتور استنتاج را دشوارتر از حد انتظار میکند. این ابزار دادههای مدل را در ساختار رجیستری اختصاصی خود و با نامهای فایل هششده (Hashed Filenames) نگه میدارد، نه بهصورت یک فایل مستقل GGUF. اگر کاربر بخواهد یک مدل خاص را با زمان اجرای دیگری استفاده کند، ممکن است لازم باشد فایل GGUF متناظر را جداگانه پیدا یا دانلود کند.
جایگزینی با llama.cpp؛ کنترل بیشتر با لایههای کمتر
مهاجرت به llama.cpp زمانی گام بعدی به نظر میرسد که کاربر کنترل بیشتری روی راهاندازی هوش مصنوعی محلی خود بخواهد. بزرگترین تفاوت این است که کاربر بهجای تکیه بر ابزاری که بیشتر فرایند را مدیریت میکند، به موتور استنتاج نزدیکتر کار میکند.
با llama.cpp میتوان مدلهای GGUF را مستقیماً اجرا کرد و انعطافپذیری آن خیلی زود نمایان میشود. کاربر میتواند تنظیماتی مانند اندازه زمینه (Context Size)، تخلیه بار روی GPU (GPU Offloading) و پارامترهای نمونهگیری (Sampling Parameters) را برای هر مدل و سختافزار خود تنظیم کند. پیکربندی همهچیز تلاش بیشتری میطلبد، اما در عوض درک روشنتری از آنچه در پشت صحنه میگذرد به دست میآید.
مزیت دیگر llama.cpp سرور داخلی آن است که یک API سازگار با OpenAI (OpenAI-Compatible API) ارائه میدهد. این یعنی میتوان رابطهای کاربری و برنامههای سازگار را بدون بازسازی کل جریان کاری به آن متصل کرد. کاربر لازم نیست فقط به دلیل تغییر بکاند، راحتی استفاده از ابزارهای هوش مصنوعی محلی را کنار بگذارد. llama.cpp بهاندازه Ollama برای مبتدیان آسان نیست، اما کنترل بیشتر آن را برای استفادههای امروزی مناسبتر میکند.
شروع ساده، مهاجرت در زمان مناسب
Ollama همچنان برای کسانی که نخستین گامها را در هوش مصنوعی محلی برمیدارند منطقی است و توصیه نمیشود مبتدیان از آن دوری کنند. اما با رشد نیازها، کاربر به ابزارهایی نیاز پیدا میکند که کنترل بیشتری روی نحوه اجرای همهچیز بدهند. به همین دلیل llama.cpp انتخاب فعلی نویسنده است. لازم نیست کار را با پیشرفتهترین تنظیمات شروع کنید؛ با آنچه کار میکند آغاز کنید، در مسیر یاد بگیرید و زمانی که ابزار فعلی محدودتان کرد، مهاجرت کنید.