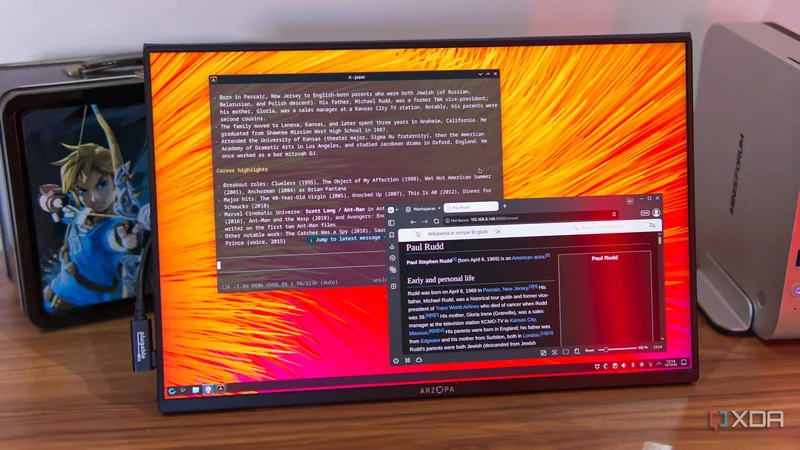
در دورانی که بیشتر پاسخها را میتوان با یک جستوجوی اینترنتی پیدا کرد، وابستگی به اتصال شبکه همیشه وجود دارد. یک کاربر برای رفع این محدودیت، ویکیپدیا را دانلود و با Kiwix روی سرور خانگی خود میزبانی کرد تا حتی هنگام قطع اینترنت به اطلاعات دسترسی داشته باشد.
میزبانی ویکیپدیا سختتر از تصور نبود
با وجود حجم عظیم ویکیپدیا، میتوان آن را روی رایانه شخصی هم جای داد؛ تنها ابزار لازم یک سرویس خودمیزبان (self-hosted) به نام Kiwix است. این کاربر Kiwix را در آزمایشگاه خانگی Proxmox خود و با اسکریپت انجمن (community script) مربوطه مستقر کرد و فقط حجم دیسک را از مقدار پیشفرض ۴GB به ۱۰GB افزایش داد تا پایگاه داده ویکیپدیا در آن جا شود.
او میتوانست نسخههای مختلف پایگاه داده ویکیپدیا را دانلود کند، حتی اگر فقط قصد نگهداشتن همه مقالات انگلیسی را داشت. برای این کار باید در ترمینال کانتینر به پوشه data میرفت و با wget فایل موردنظر را از فهرست پایگاههای داده دریافت میکرد. برای جا شدن در کانتینر نسبتاً کوچک، نسخه انگلیسی ساده (Simple English) ویکیپدیا و بهطور خاص گونه nopic را انتخاب کرد که هیچ تصویری از مقالات را شامل نمیشود. این پایگاه داده کمی بیش از ۱GB حجم دارد و بهراحتی روی هر رایانهای جای میگیرد. او وسوسه شده بود نسخه استاندارد انگلیسی را که حدود ۵۰GB است دانلود کند، اما به دلایل زمانی از این کار صرفنظر کرد.
Kiwix در عمل چگونه است
پس از دانلود پایگاه داده و راهاندازی مجدد Kiwix برای بارگذاری آن، حجم زیادی از اطلاعات در دسترس قرار میگیرد. هر پایگاه دادهای که دانلود شود بهصورت یک کتاب (book) جداگانه نمایش داده میشود، بنابراین میتوان چند گونه مختلف را نگه داشت؛ چه برای تمرکز بر حوزههای مطالعاتی خاص و چه برای داشتن نسخههای زبانی متفاوت ویکیپدیا.
نسخه انگلیسی ساده ویکیپدیا ممکن است اطلاعات کمتری داشته باشد، اما میتوان پاول راد (Paul Rudd) را جستوجو کرد و فهرست فیلمهایی را دید که در آنها بازی کرده است. در واقع تقریباً هر موضوع یا شخصی را میتوان جستوجو کرد و یک نمای کلی نسبتاً پایه از آن به دست آورد. صفحهها تقریباً شبیه نسخه اینترنتی ویکیپدیا به نظر میرسند و لینکها نیز حفظ شدهاند. هرچند صفحههای ویکیپدیا بدون اینترنت قابل مشاهدهاند، لینکهای موجود طبیعتاً به اتصال آنلاین نیاز دارند؛ با این حال وجودشان ارزشمند است. میتوان مهمترین اطلاعات را آفلاین دید و در صورت نیاز به بررسی منابع، در صورت وجود اتصال اینترنت این کار بهراحتی انجام میشود.
پرسش از ویکیپدیا با زبان طبیعی
پس از راهاندازی ویکیپدیای شخصی، کاربر میخواست ببیند آیا میتواند با زبان طبیعی از آن پرسش کند یا نه. این بخش کار بیشتری برد. نخست باید یک سرور MCP راهاندازی میکرد که بتواند از Kiwix پرسوجو کند. او یک نمونه مشخص را انتخاب کرد، هرچند نمونههای دیگری هم برای تعامل با آرشیوهای ZIM که Kiwix بر آنها تکیه دارد وجود دارد. او مجبور شد فایل اصلی build این سرور MCP را اصلاح کند، چون پارامتر capabilities را اعلام میکرد که به نظر میرسید وجود ندارد. پس از حذف آن بخش مشخص از فایل main.ts، توانست با npm سرور MCP را build و اجرا کند.
سپس با llama.cpp یک مدل زبانی بزرگ (LLM) برای استفاده آفلاین دانلود کرد. او Qwen3.8-27B را انتخاب کرد. ابتدا نسخه تقطیرشده ۴B این مدل را امتحان کرد، اما اطلاعات نادرست زیادی دریافت کرد و ناچار شد به مدل و سختافزار قویتری ارتقا دهد. این بخش از راهاندازی را روی یک واحد بررسی Minisforum AI X1 Pro که در اختیار داشت اجرا کرد؛ دستگاهی با پردازنده AMD Ryzen AI 9 HX 370 و ۶۴GB حافظه DDR5 RAM.
در نهایت به یک هارنس عامل (agent harness) نیاز داشت تا MCP و LLM را به هم وصل کند و بتواند پرسشهای زبان طبیعی بپرسد. او Pi را نصب کرد، سرور MCP را به پیکربندی افزود و آن را به مدل llama.cpp روی دستگاه متصل کرد. یک تنظیم خاص که در Pi باید تغییر میداد، تغییر نمایش سرور MCP از حالت پیشفرض codemode به direct بود؛ در غیر این صورت Pi هنگام پرسیدن هر سؤال ظاهراً سرور MCP را دور میزد. با انجام همه این کارها، او توانست از Pi درباره مقالات پرسش کند و Pi واقعاً بدون اتصال به اینترنت از سرور Kiwix او پاسخ میگرفت. البته دریافت پاسخ چند دقیقه طول میکشید.
دقت پاسخها؛ نقطهقوت و ضعف
هرچند این راهاندازی کار کرد، کاربر هنگام تنظیم آن مشکلاتی هم دید که ممکن بود دلیل نیاز به یک مدل ۲۷ میلیارد پارامتری برای گرفتن پاسخهای قابل استفاده باشد. هنگام فراخوانی ابزارهای فعالشده توسط سرور MCP، محتوای هدف بهصورت متن ساده همراه با همه تگهای HTML تجزیه میشد و سپس در مرحله بعد بهصورت خام حذف میشد؛ این کار میتوانست باعث هدر رفتن توکنها و استخراج ضعیفتر اطلاعات شود.
شاید به همین دلیل استفاده از یک مدل ۴ میلیارد پارامتری پاسخهای بیمعنی میداد. وقتی پرسید «Who is Paul Rudd?»، مدل جزئیات پایه مانند نام و تاریخ تولد را درست گفت، اما فیلمشناسی کاملاً ساختگی بود. با ارتقا به مدل ۲۷ میلیارد پارامتری، پاسخها بسیار نزدیکتر به واقعیت شد، اما هنوز بینقص نبود. مدل بیشتر جزئیات فیلمشناسی پاول راد را درست گفت، جز اینکه ادعا کرد نام شخصیت او در دنیای سینمایی مارول (Marvel Cinematic Universe) پیت پترسون (Pete Peterson) است؛ در حالی که باید اسکات لنگ (Scott Lang) باشد. همچنین فیلمی ساختگی به نام Down and Out with the Ducks را از خود ساخت. جالب اینکه این خطاها در اجرای دوم پرسوجو تکرار نشدند.
او همچنین پرسید «What is the Nintendo Switch 2?» و در این مورد پاسخ تقریباً کاملاً دقیق بود. مدل تاریخ دقیق رونمایی و عرضه در آمریکا را گفت، همه مشخصات کلیدی را بهدرستی برجسته کرد و حتی اطلاعاتی درباره عناوین اولیه آن پلتفرم ارائه داد که همه درست بودند. مدل اشاره کرد کنسول در ۸ اوت در کانادا عرضه شده است، اما پس از بررسی Kiwix مشخص شد این اطلاعات در پایگاه داده ویکیپدیا هم اشتباه بوده و مشکل از مدل نیست. تفاوت اصلی میان این دو پرسش، اندازه صفحه و وجود یک جدول نسبتاً طولانی در صفحه پاول راد در ویکیپدیای انگلیسی ساده است. تگهای HTML آن جدول ممکن بود بخش قابلتوجهی از توکنها را در پردازش درخواست مصرف کرده و هنگام اسکن ادامه صفحه، کیفیت خروجی را کاهش داده باشد.
جمعبندی
حتی اگر پاسخهای دریافتشده از LLM کاملاً با اطلاعات Kiwix مطابق نباشند، کل این فرآیند تا حدی شگفتانگیز است. صرف داشتن ویکیپدیای شخصی که میتوان آفلاین از آن استفاده کرد از قبل بسیار جالب است، اما وقتی یک LLM محلی هم برای پرسوجو از آن پایگاه داده و پاسخدادن به پرسشها راهاندازی میشود، بدون نیاز به اینترنت بهتر هم میشود. ممکن است برخی شکافها وجود داشته باشد، اما این سیستم نسبتاً خوب کار میکند.