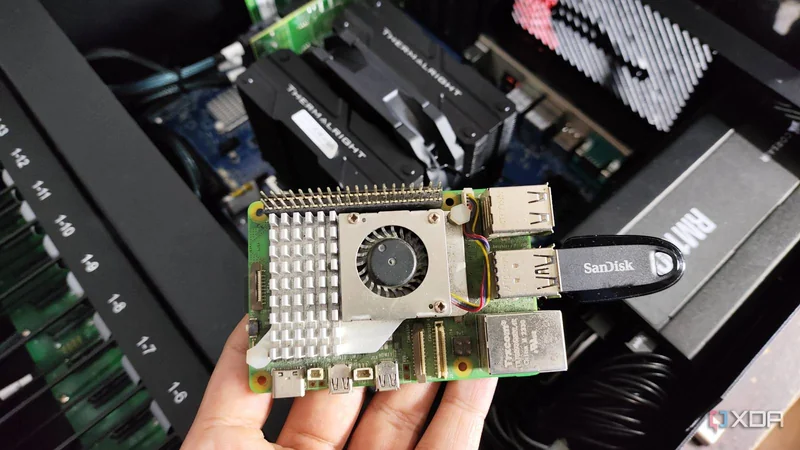
وقتی صحبت از اجرای محلی مدلهای هوش مصنوعی میشود، معمولاً سرورهای حجیم مجهز به کارتهای گرافیک قدرتمند به ذهن میآید. اما تجربههای عملی نشان میدهد مدلهای زبانی بزرگ (Large Language Models) با دهها میلیارد پارامتر تنها گزینه برای برآورده کردن نیازهای بهرهوری نیستند. بسته به نوع وظیفه، حتی یک رزبریپای ۵ به عنوان یک برد تکبرد (Single-Board Computer) هم میتواند ابزارهای هوش مصنوعی لبه (Edge AI) مفیدی را اجرا کند.
Gemma 4 E2B و E4B روی رزبریپای ۵
مدلهای کمپارامتر معمولاً به توان استدلال محدود و تمایل به ورود به حلقههای توهم (Hallucination) در پاسخ به حتی پرسشهای ساده شهرت دارند. با این حال، خانواده Gemma 4 استثناست. مدلهای E2B و E4B در این خانواده میتوانند در برابر اپلیکیشنهای بهرهوری متعارف عمل کنند.
این مدلها معماری ویژهای دارند: هر لایه رمزگشایی جدول تعبیهسازی اختصاصی (Per-Layer Embedding Table) دارد تا به جای محاسبات پیچیده برای هر پرسوجو، جستوجوی سریع انجام شود. E2B در مجموع ۵.۱ میلیارد پارامتر دارد اما تنها ۲.۳ میلیارد پارامتر محاسباتی فعال دارد. E4B نیز با ۸ میلیارد پارامتر کل، در استنتاج فعال مانند مدلی با ۴.۵ میلیارد پارامتر رفتار میکند.
با موتور استنتاج llama.cpp، یک رزبریپای ۵ با ۸ گیگابایت رم میتواند Gemma 4 E2B را با سرعت ۵.۸ تا ۶.۵ توکن بر ثانیه (tokens/second) اجرا کند؛ آن هم در حالی که فایل پروجکتور چندوجهی (Multi-Modal Projector) برای تشخیص تصویر فعال است. Gemma 4 E4B کندتر است و روی این برد تنها ۲.۵ تا ۳ توکن بر ثانیه تولید میکند.
این سرعت برای گفتوگوی معمولی یا کدنویسی پیچیده کافی نیست، اما برای خلاصهسازی نشانکهای Karakeep، انجام اسکن OCR روی Paperless-GPT یا برچسبگذاری خودکار یادداشتهای Blinko بیش از اندازه کافی است. به این ترتیب، یک نمونه Gemma 4 E4B یا حتی E2B روی رزبریپای ۵ میتواند جای ChatGPT و دیگر پلتفرمهای ابری را در این وظایف بگیرد.
Needle 3؛ مدل تخصصی برای فراخوانی ابزار و خودکارسازی
Cactus Compute Needle 3 یکی از مدلهای تازهای است که روی رزبریپای ۵ آزمایش شده و به روشی محبوب برای اجرای وظایف هوش مصنوعی روی این برد تبدیل شده است. این مدل یک LLM همهمنظوره نیست؛ قابلیت گفتوگو و تولید متن باز را کنار میگذارد و به عنوان مدلی تخصصی فقط برای فراخوانی ابزار (Tool Calls)، استخراج فیلدهای داده و ساخت تعبیههای متنی (Text Embeddings) عمل میکند.
Needle 3 حداکثر ۱۲۱ میلیون پارامتر دارد و به لطف طراحی لایهای، میتوان زیرشبکههایی با عمق کمتر را برای صرفهجویی در منابع روی دستگاههای بسیار کمرم، از جمله میکروکنترلرها، مستقر کرد. این مدل روی رزبریپای زیرو نسل اول به دلیل معماری پردازنده قدیمی اجرا نشد، اما روی رزبریپای ۵ عملکرد خوبی دارد.
در یک آزمایش، یک فایل پایتون ساده برای اتصال Needle 3 به Home Assistant و کنترل یک پریز هوشمند ساخته شد. پس از دادن اسکریپت به نمونه Needle 3 با هر ۲۰ لایه و اجرای یک پرسوجوی گفتوگویی برای روشن کردن پریز، مدل بلافاصله خودکارسازی درست را اجرا کرد؛ با نرخ رمزگشایی ۲۸۰.۲ توکن بر ثانیه و مقدار پیشپرکردن (Prefill) برابر ۹۹۶.۴ توکن بر ثانیه. فرمانهای مدیریت Docker و دیگر فراخوانیهای ابزار Home Assistant نیز تا زمانی که تنظیمات پایتون درست بود، بیمشکل کار کردند. استفاده از آن به آسانی LLMها نیست، اما برای کسانی که حاضرند کد پایتون سفارشی بنویسند، ترکیب رزبریپای و Needle 3 گزینهای کارآمد برای خودکارسازیهای مبتنی بر هوش مصنوعی است.
مدلهای Embedding و YOLO
رزبریپای همچنین میتواند به عنوان گره ثانویه سرور خانگی، مدلهای تعبیهسازی (Embedding Models) را اجرا کند. این مدلها متن و تصویر را به بردارهای عددی تبدیل میکنند و ورودیهای مشابه را در فضای چندبعدی کنار هم قرار میدهند. اپلیکیشنهایی که از تولید افزوده با بازیابی (Retrieval-Augmented Generation) پشتیبانی میکنند، از این نگاشتهای برداری برای تزریق زمینه اضافی به LLM استفاده میکنند تا پاسخها دقیقتر شوند و احتمال توهم کاهش یابد.
در یک آزمایشگاه خانگی، Paperless-ngx، Open Notebook و Blinko برای دریافت اطلاعات از اسناد و یادداشتها به مدلهای Embedding وابستهاند. کاربر گاهی از nomic-embed-1.5 روی رزبریپای ۵ برای ساخت این نگاشتهای برداری استفاده میکرده است. همچنین کیت هوش مصنوعی رزبریپای (Raspberry Pi AI Kit) از LLMهای معمول پشتیبانی نمیکند، اما میتواند YOLOv8 را برای تشخیص اشیاء (Object Detection) ساده در تصاویر دوربینهای امنیتی و سرور Frigate اجرا کند.