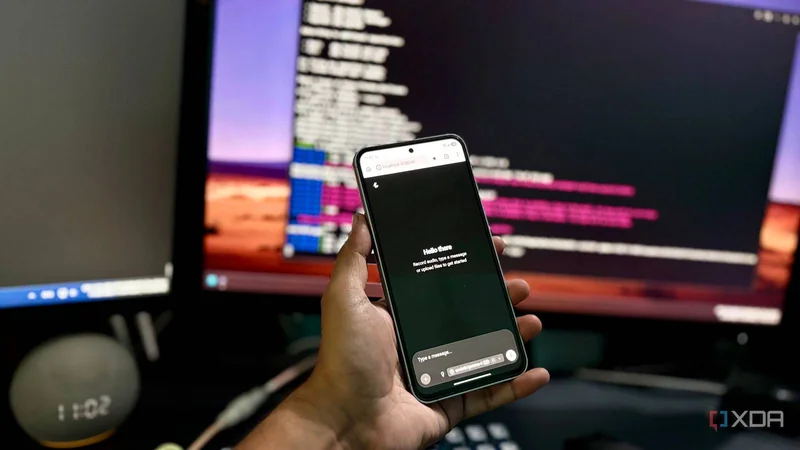
یک کاربر با استفاده از گوشی قدیمی سامسونگ گلکسی S23 FE نسخه Exynos 2200 با ۸ گیگابایت حافظه رم (RAM) تلاش کرده است یک مدل زبانی محلی (Local LLM) را روی اندروید اجرا کند. هدف او کاهش وابستگی به سرویسهای ابری مانند ChatGPT و Claude و انتقال بخشی از کارهای روزمره به گوشی بود. نتیجه اولیه نشان میدهد این کار ممکن است، اما محدودیتهای جدی در عملکرد و مدیریت منابع دارد.
PocketPal و Termux؛ دو مسیر برای اجرای مدل
او ابتدا اپلیکیشن PocketPal را آزمود که امکان دانلود مدل و رابط چت داخلی را فراهم میکند. در این برنامه مدل کوچک Gemma 3 1B بدون کاهش فرکانس گوشی اجرا شد، اما مدل Gemma 4 E2B هنگام بارگذاری باعث کرش (Crash) اپلیکیشن شد. سپس با نصب بسته llama-cpp در Termux و بارگذاری نسخه Q4_K_M از Gemma 4 E2B با حجم حدود ۲.۸ گیگابایت و حدود ۴.۶۵ میلیارد پارامتر، سرور محلی (Local Server) روی localhost:8080 راهاندازی شد.
عملکرد ناامیدکننده در پسزمینه
در تست اولیه از طریق رابط وب llama، سرعت تولید توکن (Token Generation) حدود ۰.۱ توکن بر ثانیه بود و پاسخدهی بسیار کند پیش میرفت. بررسی تنظیمات باتری Termux، غیرفعال بودن حالت خواب اپلیکیشنهای بلااستفاده و خاموش بودن صرفهجویی انرژی نشان داد مشکل از تنظیمات قدرت نیست. آزمایش مدل کوچکتر Qwen 3.5 2B نیز در Termux عملکرد ضعیفی داشت.
تفاوت چشمگیر وقتی Termux در پیشزمینه است
اجرای آزمون llama-bench از طریق SSH نشان داد وقتی Termux در پیشزمینه (Foreground) قرار دارد، سرعت بهشدت بهتر میشود. برای Qwen 3.5 2B در تست کوتاه، پردازش درخواست (Prompt Processing) از ۱.۶۸ به ۲۴.۲۹ توکن بر ثانیه و تولید توکن از ۰.۱۷ به ۱۳.۳۳ توکن بر ثانیه رسید. برای Gemma 4 E2B نیز تولید توکن از حدود ۰.۱ به ۱۱.۳۹ توکن بر ثانیه افزایش یافت؛ یعنی حدود ۱۰۰ برابر بهبود.
نویسنده فرضیه میدهد اندروید برنامههای بدون پنجره قابلمشاهده را محدود میکند و در گوشی سامسونگ تنها سه هسته (Core) به برنامههای گروه پسزمینه (Background Group) اختصاص مییابد. راهحل عملی، اجرای همزمان Termux و Chrome در حالت تقسیم صفحه (Split Mode) بود. با این روش سرعت Gemma 4 E2B به حدود ۵.۴ تا ۶.۶ توکن بر ثانیه رسید و در تست فشار، ۷۳۰ توکن در ۲ دقیقه و ۴ ثانیه تولید شد.
کیفیت پاسخها و محدودیتهای مدلهای کوچک
در PocketPal، مدل Qwen 3.5 2B با بنچمارک داخلی ۵۴.۵۴ توکن بر ثانیه در پیشپردازش و ۱۱.۱۴ توکن بر ثانیه در تولید اجرا شد و در تست واقعی حدود ۹ توکن بر ثانیه داشت. با این حال، بسیاری از خروجیها توهمزایی (Hallucination) داشتند و اطلاعات نادرست تولید میکردند. در مقابل، Gemma 4 E2B برای کارهایی مانند خلاصهسازی، پاسخ به ایمیل و محاسبات فنی ساده پاسخهای دقیقتری ارائه داد.
نتیجه: جایگزین نیست، اما شروع خوبی است
این آزمایش نشان میدهد گلکسی S23 FE نمیتواند جایگزین کامل ChatGPT یا Claude باشد، اما برای کارهای سبک و عمومی میتواند بهعنوان گزینه اول مورد استفاده قرار گیرد. دو شرط مهم وجود دارد: نگهداشتن Termux و مرورگر در حالت تقسیم، و بازبینی همیشگی خروجیها به دلیل کوچک بودن مدل. نویسنده قصد دارد همین تنظیمات را روی یک گوشی اندرویدی غیرسامسونگ نیز آزمایش کند تا مشخص شود محدودیت زمانبندی پیشزمینه (Foreground Scheduling) مربوط به اندروید است یا سامسونگ.