در حالی که بسیاری از کاربران برای دسترسی به قابلیتهای پیشرفته هوش مصنوعی به سرویسهای ابری و اشتراکهای ماهانه روی میآورند، گروهی از علاقهمندان ترجیح میدهند مدلها را بهصورت محلی (Local) و روی سختافزار شخصی خود اجرا کنند. یکی از نویسندگان XDA Developers پس از ماهها آزمایش دهها مدل زبانی محلی (Local LLM)، به الگویی عملی رسیده است: بهجای جستوجوی یک مدل همهکاره، سه مدل تخصصی را برای سه وظیفه مشخص در اختیار دارد.
این مجموعه روی سیستمی با کارت گرافیک RTX 4070 Ti Super با ۱۶ گیگابایت حافظه ویدیویی (VRAM) و پردازنده Ryzen 5 7600X اجرا میشود؛ سختافزاری که در ابتدا تنها برای بازی در رزولوشن 1440p خریداری شده بود.
مدل نخست: BigBang-v1 برای پژوهش عمیق و جستوجوی وب
نخستین مدل، BigBang-v1 نام دارد و نسخهای تنظیمشده (Fine-tuned) از مدل Qwen3.6-35B-A3B است که تحت پروانه Apache 2.0 منتشر شده است. ویژگی شاخص آن، عملکرد قابل توجه در آزمون سنجش (Benchmark) BrowseComp است؛ آزمونی که توانایی مدل در یافتن اطلاعات دشوار در وب را میسنجد و BigBang-v1 در آن امتیاز ۷۶٫۵ را ثبت کرده است.
از آنجا که مدل پایه از معماری ترکیبی متخصصها (MoE) بهره میبرد و برای هر توکن تنها ۳ میلیارد از ۳۵ میلیارد پارامتر خود را فعال میکند، سرعت تولید متن آن از سرعت مطالعه انسان روی این سختافزار بیشتر است.
- حجم وزنهای نسخه کوانتیزه IQ4_XS ساخت bartowski برابر ۱۹٫۳ گیگابایت است که از ظرفیت حافظه ویدیویی بیشتر است.
- برای جا شدن مدل، حدود ۷ گیگابایت از آن با استفاده از پرچم --n-cpu-moe به حافظه رم سیستم منتقل میشود.
- با پنجره زمینه (Context Window) ۱۲۸ هزار توکنی، سرعت تولید ۶۸ تا ۷۸ توکن بر ثانیه گزارش شده است.
در آزمون عملی، رابط وب llama.cpp از طریق پروتکل MCP به موتور جستوجوی Exa با یک کلید API رایگان متصل شد و از مدل پرسشی درباره تازهترین مشکلات شناختهشده ویندوز ۱۱ نسخه 26H2 پرسیده شد؛ موضوعی که پس از تاریخ پایان دادههای آموزشی مدل قرار میگرفت. مدل با تنها پنج جستوجو همه موارد تأییدشده مایکروسافت را همراه با تاریخ و شماره بسته بهروزرسانی (KB) درست بازیابی کرد، هرچند یک مورد اضافه نیز تولید کرد که در منابع مایکروسافت یافت نشد؛ نکتهای که ضرورت بازبینی منابع را یادآوری میکند.
مدل دوم: FLUX 3 Image Klein برای تولید و ویرایش تصویر
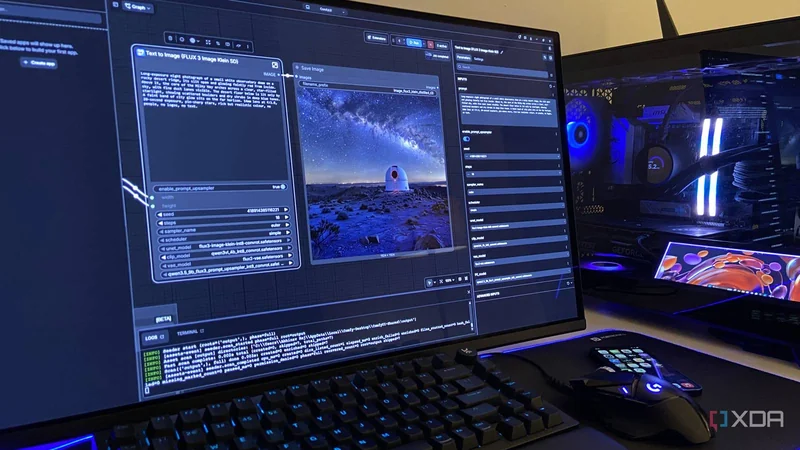
کوچکترین عضو این مجموعه، FLUX 3 Image Klein با ۵٫۶ میلیارد پارامتر است که هم برای تولید و هم برای ویرایش تصویر از همان وزنها استفاده میکند. نسخه تقطیرشده (Distilled) آن در محیط ComfyUI تنها به ۱۶ گام (Step) برای هر تصویر نیاز دارد.
این مدل تحت پروانه FLUX Kommunity License عرضه شده و استفاده غیرتجاری را مجاز میداند؛ همچنین استفاده تجاری برای کسبوکارهایی با درآمد سالانه کمتر از ۵ میلیون دلار، مشروط به رعایت شرایط، permitted است.
اجرای این مدل به دو مدل کمکی نیز وابسته است: یک مدل Qwen3.5 با ۹ میلیارد پارامتر بهعنوان بازنویسیکننده و غنیساز پرامپت (Prompt Upsampler) و یک مدل Qwen3-VL با ۴ میلیارد پارامتر بهعنوان رمزگذار متن (Text Encoder). هر سه مدل در نسخه INT8 استفاده میشوند و ComfyUI هر یک را در مرحله مربوط به خود در حافظه ویدیویی بارگذاری میکند.
- تولید یک تصویر ۱۰۲۴ در ۱۰۲۴ پیکسل بهطور میانگین حدود ۱۶ ثانیه زمان میبرد.
- فرایند نمونهبرداری (Sampling) تنها حدود ۴ ثانیه از این زمان را میگیرد و بخش عمده باقیمانده صرف تولید پرامپت گستردهتر توسط مدل غنیساز میشود.
- چون همهچیز محلی اجرا میشود، هیچ محدودیت مصرف، واترمارک یا سقف درخواست وجود ندارد.
البته نویسنده اذعان دارد که کار با رابط ComfyUI در وضعیت کنونی برای کاربران تازهکار چندان آسان نیست.
مدل سوم: Qwen3.8-27B برای کدنویسی
برای نوشتن کد، مدل متراکم (Dense) Qwen3.8-27B انتخاب شده است. در آزمون SWE-bench Pro، این مدل امتیاز ۶۱٫۷ را در برابر ۵۴٫۲ مدل BigBang-v1 کسب کرده است؛ هرچند هر دو عدد توسط سازندگان گزارش شدهاند. تجربه عملی نویسنده نیز کیفیت کد این مدل را بهتر نشان میدهد.
هزینه این کیفیت، سرعت است: چون مدل متراکم است، هر ۲۷ میلیارد پارامتر آن برای تولید هر توکن فعال میشوند و ترفند انتقال متخصصها به رم با پرچم --n-cpu-moe کاربرد ندارد. راهحل اتخاذشده، استفاده از نسخه کوانتیزه UD-IQ4_XS ساخت Unsloth با حجم ۱۴٫۳ گیگابایت است تا وزنها بهطور کامل در حافظه ویدیویی جای بگیرند.
با این حال، پنجره زمینه ۳۲ هزار توکنی نیازمند حدود ۲ گیگابایت حافظه نهان (Cache) اضافه است؛ در نتیجه زمان اجرای llama.cpp بهطور خودکار ۶ لایه از ۶۴ لایه مدل را به رم سیستم منتقل میکند و سرعت تولید به حدود ۱۵ تا ۱۷ توکن بر ثانیه میرسد. به گفته نویسنده، این سرعت برای پروژههای سرگرمی با کتابخانه Pygame کافی است و کیفیت کد، کندی تولید را جبران میکند.
نتیجهگیری: مالکیت کامل بدون هزینه اشتراک
هر سه مدل یادشده رایگاناند و تنها سرمایهگذاری لازم، همان کارت گرافیکی است که کاربر از پیش در اختیار دارد. با توجه به سرعت تحول اکوسیستم هوش مصنوعی محلی، نویسنده پیشبینی میکند که در هفتههای آینده مدلهای بهتری جای این سه مدل را بگیرند، اما سختافزار ثابت او بدون هیچ هزینه اشتراکی، کارآمدتر از گذشته خواهد بود.