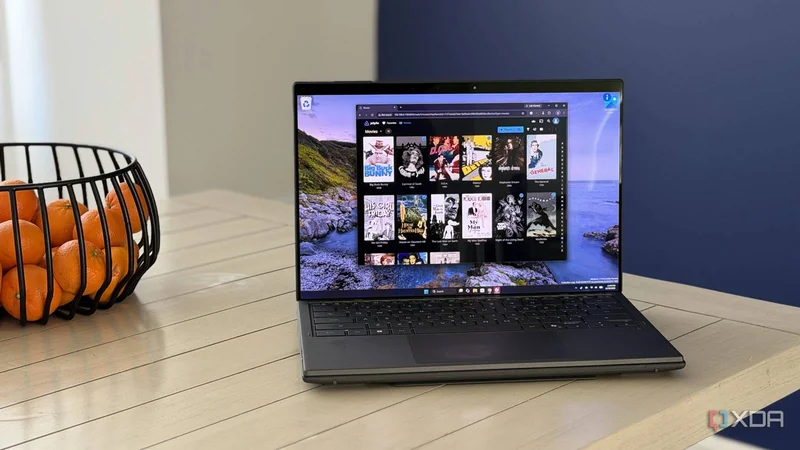
یک کاربر پس از مهاجرت از Plex به Jellyfin با مشکل آشنايی روبهرو شد: تاریخچه تماشا و دادههای مورد نیاز برای پیشنهادهای هوشمند بهدرستی منتقل نشده بود و موتور پیشنهاد داخلی Jellyfin گاهی نتیجههای بیربط میداد؛ مثلاً پس از تماشای «His Girl Friday» یک فیلم خونآشامی پیشنهاد شده بود. او بهجای اصلاح دستی همه نشانهها، کتابخانه خود را به دو مدل زبانی محلی (Local LLM) سپرد تا ببیند این مدلها بر اساس تاریخچه تماشا چه پیشنهادی میدهند.
چرا پیشنهادهای داخلی Jellyfin کافی نبود
به گفته نویسنده، ردیفهای «Because you watched» در Jellyfin لزوماً درک درستی از سلیقه کاربر ندارند. او برای آزمایش، کتابخانهای شامل ۱۵ فیلم رایگان ساخت: ۱۱ فیلم از مالکیت عمومی که از Internet Archive گرفته شده بودند (۵ ترسناک، ۳ نوآر و ۳ کمدی) و ۴ فیلم باز Blender. این ترکیب برای گرفتن پیشنهاد از مدلها کافی بود، اما برای موتور داخلی Jellyfin چندان غنی نبود.
برای اینکه آزمون منصفانه باشد، تاریخچه تماشا بهصورت دستی و عامدانه تنظیم شد؛ برخی فیلمها محبوب علامت خوردند و تاریخچه بهشکلی نامتوازن چیده شد تا هیچکدام از کمدیها یا فیلمهای Blender در فهرست تماشاشده قرار نگیرند. Jellyfin داخل یک کانتینر LXC روی سرور Proxmox نصب شده بود، مدلهای محلی با Lemonade روی همان سرور سرو میشدند و همهچیز با اسکریپتهای PowerShell کنترل میشد تا دستورها قابل تکرار باشند.
اتصال Jellyfin به مدلهای محلی بدون افزونه
نویسنده بهجای استفاده از یک افزونه، اسکریپتی نوشت که چند کار را انجام میداد: پرچمهای تماشاشده و محبوب را از طریق رابط برنامهنویسی Jellyfin (Jellyfin API) میخواند، فهرست را به نقطه پایانی سازگار با OpenAI (OpenAI-compatible endpoint) در Lemonade میفرستاد و از مدل میخواست هشت پیشنهاد رتبهبندیشده را در قالب JSON و همراه با یک جمله دلیل برای هر انتخاب برگرداند؛ دلیلی که باید نام یک فیلم تماشاشده را در خود داشته باشد.
دو مدل آزمایششده عبارت بودند از gpt-oss-120b و Qwen3.5-9B که روی پشته ROCm در Lemonade اجرا میشدند. دمای مدل (Temperature) روی ۰٫۳ تنظیم شده بود تا خلاقیت بیشتری ایجاد شود. بودجه توکن (Token Budget) ابتدا ۴٬۰۰۰ در نظر گرفته شد، اما Qwen در اولین اجرا همه آن را صرف «فکر کردن» کرد و بنابراین بودجه به ۸٬۰۰۰ افزایش یافت. این یکی از مشکلات مدلهای استدلالی محلی است: گاهی پیش از انجام کار، دور خود میچرخند.
نتایج دو مدل در دور اول
در چهار اجرا، مجموعاً ۳۲ پیشنهاد تولید شد که ۳۱ مورد واقعی بود و هیچکدام فیلمی را پیشنهاد ندادند که Jellyfin آن را تماشاشده علامت زده بود. تنها خطای واقعی، اشتباه در نام یک فیلم بود که میان نسخه اصلی ۱۹۵۱ و بازسازی بعدی آن تفاوت وجود دارد. نویسنده تأکید میکند که تقریباً همه ۳۲ پیشنهاد را با رضایت تماشا میکرد؛ نیمی از آنها فیلمهایی بودند که او جای دیگری دیده بود و صرفاً در فهرست ۱۵ فیلم آزمایشی قرار نداشتند.
- gpt-oss-120b: سریعتر بود و بیشتر شبیه یک فیلمباز حرفهای انتخاب میکرد؛ پیشنهادهایی مانند «The Innocents»، «The Cabinet of Dr. Caligari»، «The Thing From Another World» و «The Maltese Falcon» از خروجیهای آن بود.
- Qwen3.5-9B: کندتر بود و ابتدا قفسه فیلمهای موجود را خواند؛ سه پیشنهاد نخست آن از میان فیلمهای موجود در کتابخانه بود. این مدل بهدلیل وجود «Detour» در فهرست تماشاشده، چند نوآر کلاسیک و سپس ترسناکهای کلاسیک مانند «Psycho» و «The Thing» را پیشنهاد داد.
با این حال، Qwen3.5-9B یک خطای واقعی هم داشت و ادعا کرد «The Last Man on Earth» دنباله «Night of the Living Dead» است؛ در حالی که فیلم دوم چهار سال پس از فیلم اول منتشر شده بود.
تست دوم با افزودن سه کمدی محبوب
در دور دوم، سه کمدی هم تماشاشده و هم محبوب علامت خوردند و اسکریپت دوباره اجرا شد. هر دو مدل تقریباً همان زمان قبلی را صرف کردند، اما روش انتخابشان متفاوت بود. مدل 120b پنج پیشنهاد ترسناک را حفظ کرد و دو کمدی به ترکیب افزود: «Bringing Up Baby» که نویسنده ندیده بود و «Dr. Strangelove» که بارها دیده بود اما همچنان برایش جذاب است. Qwen تعادل بیشتری برقرار کرد و دو کمدی، سه نوآر و سه ترسناک پیشنهاد داد، اما این بار هم خطای واقعی داشت و عنوان «The Thing (1951)» را به کار برد، در حالی که نام درست «The Thing From Another World» بود.
تفاوت دیگر این بود که مدل 120b بیشتر بر اساس فیلمهای تماشاشده انتخاب کرد، در حالی که Qwen فهرست محبوبها را نشانه بهتری دانست. به گفته نویسنده، هیچکدام از این دو رویکرد لزوماً بهتر یا بدتر نبود؛ هر دو پیشنهادهایی منطقی دادند و هیچکدام به ژانرهایی که او چندان نمیپسندد نرفتند. برخی دلیلهای ارائهشده کمی خلاقانه یا سهلانگارانه بودند، اما چیزی نبود که مانع انتخاب فیلم شود.
جمعبندی؛ ابزاری مکمل، نه جایگزین فوری
نتیجه آزمایش این بود که هر دو مدل در این کتابخانه کوچک، پیشنهادهای بهتری از Jellyfin ارائه دادند. gpt-oss-120b در کشف فیلمهای تازه و سرعت پاسخ بهتر بود و Qwen3.5-9B در پیشنهاد از میان کتابخانه موجود عملکرد بهتری داشت. نویسنده میگوید میتوان از مدل بزرگتر برای پیدا کردن فیلمهایی که باید به کتابخانه اضافه شوند و از مدل کوچکتر برای انتخاب فیلمی که همین حالا باید تماشا کرد استفاده کرد. با این حال، این مدلها جایگزین فوری موتور پیشنهاد داخلی Jellyfin نیستند و اگر کتابخانه بزرگتر شود، شاید پیشنهادهای داخلی Jellyfin هم بهتر عمل کنند.