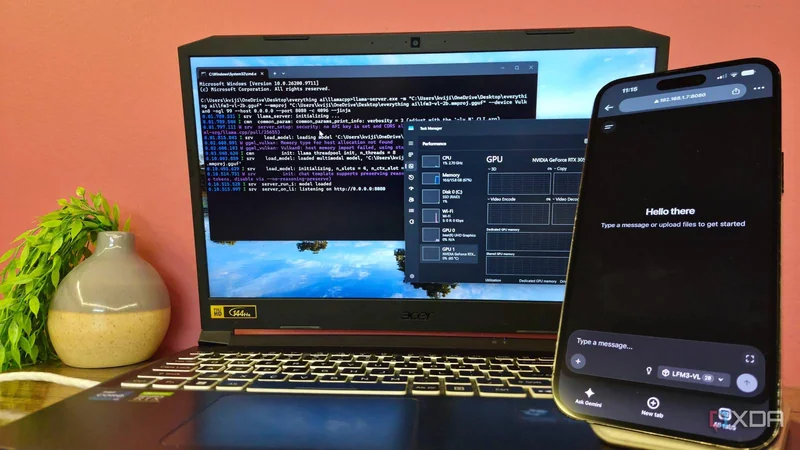
یک تجربه کاربری در XDA Developers نشان میدهد چگونه میتوان یک لپتاپ قدیمی را به سرور خانگی هوش مصنوعی تبدیل کرد، بدون اینکه گرافیک اختصاصی (Discrete GPU) آن درگیر شود. در این پروژه، مدل کوچک بینایی-زبانی (Vision-Language Model) روی گرافیک مجتمع (Integrated Graphics) پردازنده اجرا شده تا کارت RTX 3050 Ti برای وظایف سنگینتر آزاد بماند.
از سرور خانگی تا دستیار محلی برای اسناد حساس
لپتاپ Acer Nitro 5 با پردازنده Core i7-11800H، ۱۶ گیگابایت رم و کارت RTX 3050 Ti Mobile پیشتر به سرور خانگی همیشهروشن تبدیل شده بود. با این حال، نویسنده متوجه شد اعضای خانواده اسناد حساس مانند صورتحساب بانکی، مدارک بیمه، گزارشهای پزشکی و قبوض را برای توضیح و خلاصهسازی به سرویسهایی مانند Gemini و ChatGPT میفرستند. همین موضوع انگیزه ساخت یک دستیار محلی شد که اطلاعات را از شبکه خانگی خارج نکند.
اجرای مدل روی گرافیک مجتمع با llama.cpp
برای اجرای مدل روی گرافیک مجتمع Intel UHD، از نسخه Vulkan مربوط به llama.cpp استفاده شد و دستگاه به Vulkan0 محدود شد. به این ترتیب لایههای مدل روی iGPU قرار گرفتند. بررسی با فرمان nvidia-smi -l 1 نیز تأیید کرد که llama.cpp در مصرف کارت RTX سهمی ندارد. مدل انتخابشده LFM3-VL-2B از Liquid AI است؛ یک مدل کوچک بینایی-زبانی که میتواند تصاویر و اسناد را بررسی کند. برای استفاده از آن، دستکم بیلد (Build) شماره 11960 از llama.cpp یا جدیدتر لازم است.
دسترسی همه دستگاهها از طریق شبکه محلی
پس از راهاندازی استنتاج (Inference)، llama.cpp به یک سرور شبکه محلی (LAN Server) تبدیل شد تا گوشیها و لپتاپهای متصل به Wi-Fi بتوانند به آن دسترسی داشته باشند. لپتاپ از طریق کابل LAN متصل ماند و سایر دستگاهها با یک میانبر ساده در Chrome به چتبات محلی دسترسی پیدا کردند. هدف اصلی نیز حفظ همین وضعیت بود: RTX 3050 Ti همچنان برای ترنسکدینگ Jellyfin و استریم بازی با Sunshine در اختیار بماند.
محدودیتهای واقعی مدل کوچک
این مدل جایگزین ChatGPT یا Gemini نیست و توان استدلال پیچیده ندارد. سرعت تولید متن حدود ۶ توکن بر ثانیه (Tokens per Second) است. در آزمایش با یک قرارداد اجارهنامه اسکنشده دو صفحهای، ۷۰۹۸ توکن ورودی و ۲۵۲ توکن خروجی پردازش شد؛ پردازش مقدماتی (Prefill) حدود ۳۳.۳ توکن بر ثانیه، زمان تا نخستین توکن (TTFT) حدود ۲۱۳ ثانیه، تولید (Decode) حدود ۶.۱۱ توکن بر ثانیه و زمان کل پاسخ حدود ۲۵۴ ثانیه بود.
- مدل بهطور مستقیم فایل PDF را پردازش نمیکند و اسناد باید ابتدا به تصویر تبدیل یا اسکرینشات شوند.
- سرعت پایین برای استفاده تعاملی چندان مناسب نیست، اما برای دستیار پسزمینه و پردازش گاهبهگاه اسناد حساس کافی است.
- مزیت اصلی، نگهداشتن اطلاعات در شبکه محلی و آزاد ماندن گرافیک اختصاصی برای وظایف دیگر است.
به گفته نویسنده، این راهکار برای همه کاربران منطقی نیست و هدف آن کسب امتیاز عملکردی نیست؛ بلکه یک سرویس کوچک و کمهزینه است که برای یک خانه، حریم خصوصی بیشتری فراهم میکند. در این حالت، کندی مدل در برابر امنیت و کنترل دادهها پذیرفتنی است.