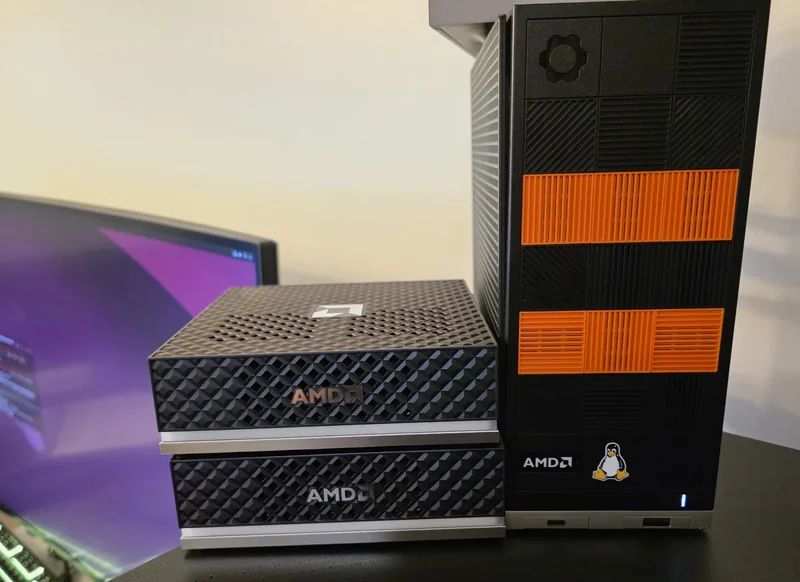
پس از انتشار نسخه ۰.۱ از HRX Loom، تیمی از مهندسان AMD با تکیه بر گردشکار عامل هوش مصنوعی (AI agent workflow) آزمایشی را برای انتقال ۵۰ مدل پرطرفدار Hugging Face به GPUهای کلاینت AMD انجام دادند. این کار در حدود سه تا چهار روز و با ترکیب نرمافزار HRX و سختافزار Ryzen AI Max Strix Halo محقق شد.
جزئیات آزمایش انتقال مدلها
این آزمایش را جرمی فاورز (Jeremy Fowers) و بن وانیک (Ben Vanik) از مهندسان AMD هدایت کردند. هدف، نشان دادن توانایی HRX Loom و هوش مصنوعی عاملمحور برای آوردن سریعتر مدلهای جدید و حتی مدلهای کمکاربردتر به سختافزار AMD بوده است. در این پروژه، ۵۰ مدل محبوب Hugging Face در قالب ۱۸ معماری (architecture) مختلف به GPUهای کلاینت AMD منتقل شدند.
بهبود سرعت پردازش پرامپت
بر اساس نتایج این آزمایش، پردازش پرامپت ۳۲ هزار توکن (32K token prompt processing) در مقایسه با بکاند ROCm در Llama.cpp به طور میانگین ۱.۵ تا ۲.۱ برابر سریعتر شده است. همچنین در مقایسه با بکاند Vulkan در Llama.cpp، بهبود ۱.۹ برابری گزارش شده است.
- انتقال ۵۰ مدل Hugging Face در ۱۸ معماری مختلف
- انجام آزمایش در حدود سه تا چهار روز
- بهبود ۱.۵ تا ۲.۱ برابری در پردازش پرامپت ۳۲ هزار توکن نسبت به بکاند ROCm در Llama.cpp
- بهبود ۱.۹ برابری نسبت به بکاند Vulkan در Llama.cpp
- پشتیبانی از اجرا روی GPU، CPU و NPU
HRX Loom؛ پروژهای آزمایشی با پتانسیل بالا
HRX Loom در حال حاضر در AMD یک پروژه آزمایشی (experimental project) محسوب میشود، اما نتایج بهدستآمده پتانسیل بالای آن را نشان میدهد. این پروژه تنها محدود به GPU نیست و از اجرا روی CPU و NPU نیز پشتیبانی میکند. علاقهمندان میتوانند نتایج این آزمایش را در صفحه GitHub پروژه Loom-Fun مشاهده کنند.
loom-skills و تمرکز بر Strix Halo
بخشی از این کار، ارائه loom-skills برای تجهیز Claude Code، Codex یا Pi agent به اجزای لازم جهت نویسندگی و سرویسدهی برنامههای مدل بهینهشده (optimized model programs) روی GPUهای کلاینت AMD است. تمرکز و آزمایش فعلی روی سختافزار Strix Halo از جمله Ryzen AI Halo یا Framework Desktop قرار دارد. اطلاعات پسزمینه بیشتر درباره Loom در مستندات AMD قابل دسترسی است.