هر چند هفته یک مدل زبانی جدید با وزنهای باز (Open-Weight) منتشر میشود و معمولاً نسخهای که همه بررسیها درباره آن است، همان نسخهای نیست که روی کارت گرافیک ۸ گیگابایتی قابل اجراست. زیر هر انتشار، کامنتها تقریباً ثابت میمانند و همیشه کسی توصیه میکند برای کارت ۱۶ یا ۲۴ گیگابایتی پسانداز کنید. اما واقعیت این است که بخش عمده کارهای روزمره روی رایانه شخصی، امروز نیازی به بیش از ۸ گیگابایت حافظه گرافیکی (VRAM) ندارد.
به همین دلیل، پروژههای سنگینتر همچنان به مدلهای ابری (Cloud Models) سپرده میشوند؛ از پژوهشهای بزرگ و کارهای طراحی گرفته تا ساخت ابزارهای مختلف. با این حال، پردازش محلی (Local Processing) جایگاه خود را حفظ کرده است؛ بهویژه برای اسنادی که ترجیح میدهیم از مراکز داده بیرون بمانند، مانند قراردادها، اوراق حقوقی، اسناد مالی و اطلاعات مرتبط با سلامت. اینها کارهای کوچکی هستند که مدلهای کوچک بهخوبی از عهدهشان برمیآیند.
Gemma 4 E4B؛ گزینهای مطمئن با پشتیبانی از تصویر و صدا
گوگل مدل Gemma 4 را در آوریل ۲۰۲۶ منتشر کرد و E4B یکی از دو مدل کوچک این خانواده است که برای گوشی و لپتاپ ساخته شده است. حرف E به پارامترهای مؤثر (Effective Parameters) اشاره دارد؛ یعنی مدل در مجموع ۸ میلیارد پارامتر دارد، اما بخش زیادی از آنها در جدولهای تعبیهسازی لایهای (Per-Layer Embedding Tables) قرار گرفتهاند که تنها برای جستوجوی سریع به کار میروند؛ در نتیجه رفتار مدل بیشتر شبیه یک مدل ۴.۵ میلیاردی است.
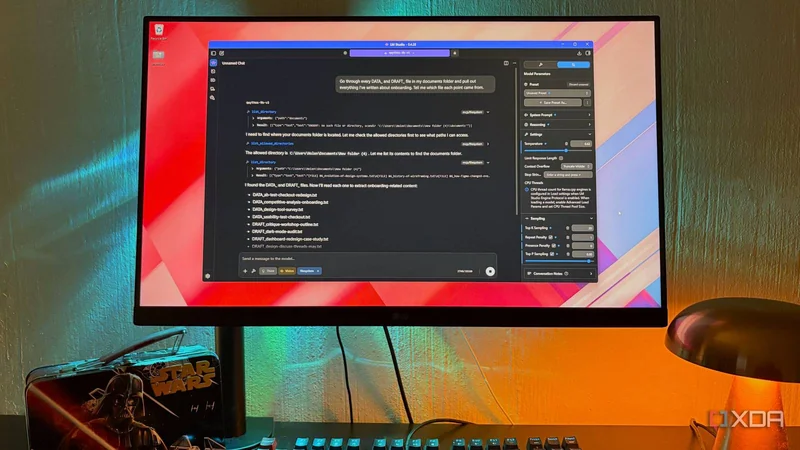
این مدل با کوانتایز Q4_K_M در نرمافزار LM Studio اجرا میشود و تنها مدل این مجموعه است که توانایی خواندن تصویر و پردازش ورودی صوتی را نیز دارد. نکته مهم درباره چنین مدلهای کوچکی، دامنه دانش آنهاست؛ بنچمارکهای خود گوگل امتیاز E4B را در آزمون MMLU Pro حدود ۶۹.۴ درصد ثبت کردهاند، در حالی که نسخه ۳۱ میلیاردی به ۸۵.۲ درصد میرسد. بنابراین دادههای آموزشی آن قابل قبول است، اما صحت پاسخها همچنان باید راستیآزمایی شود.
این مدل از فراخوانی تابع بومی (Native Function Calling) پشتیبانی میکند و در این زمینه بهتر از انتظار اولیه عمل میکند؛ فراخوانی سرورهای MCP مربوط به وب و سیستم فایل را بهدرستی انجام میدهد. کاربرد اصلی آن، پژوهش شخصی و خلاصهسازی اطلاعات است؛ بهویژه سادهسازی گزارشهای پیچیده پزشکی یا بندهای دشوار قراردادها. چون از قابلیت بینایی (Vision) برخوردار است، نیازی به بارگذاری کل سند یا کپیکردن حجم زیادی از متن نیست و میتوان تنها یک تصویر از سند گرفت و در گفتوگو بارگذاری کرد.
DeepSeek R1 Distill Llama 8B؛ قدیمی اما کارآمد در استدلال
این مدل در تقویم مدلهای زبانی محلی قدیمی به حساب میآید، اما همچنان کاربردی است. دیپسیک آن را در ژانویه ۲۰۲۵ همراه با R1، مدل بزرگ استدلالی خود، منتشر کرد. پایه آن Llama 3.1 8B شرکت متا است که دیپسیک آن را با حدود ۸۰۰ هزار نمونه از فرایند حل مسئله مرحلهبهمرحله R1 بازآموزی کرده و در نتیجه привыک عادت «بلند فکر کردن» پیش از پاسخ را به ارث برده است.
نسخه ۷ میلیاردی مبتنی بر Qwen نیز وجود دارد که در بنچمارکهای ریاضی و علمی دیپسیک امتیاز بالاتری کسب میکند، هرچند نسخه Llama در برنامهنویسی کمی بهتر عمل میکند. این مدل با کوانتایز Q4_K_M حدود ۴.۹ گیگابایت حافظه اشغال میکند و نقطه قوت آن ریاضیات و منطق است؛ از محاسبات بودجه گرفته تا مقایسه هر چیزی که با اعداد سر و کار دارد.
افزون بر این، در خواندن انبوهی از یادداشتهای نامنظم و یافتن علت مشترک چند مسئله جداگانه نیز توانمند است. بیشترین بهرهگیری از آن در بخش «بلوک تفکر» (Thinking Block) رخ میدهد؛ جایی که میتوان تمام مراحل استدلال را پیش از اعتماد به پاسخ نهایی بررسی کرد.
FluentlyQwen3-Coder-4B؛ کوچکترین عضو مجموعه برای ساخت ابزارهای شخصی
هر ابزار کوچکی نیازمند مدل ابری نیست. FluentlyQwen3-Coder-4B یک تنظیم دقیق (Fine-Tune) جامعهمحور از پروژه Fluently است و انتشار رسمی Qwen به شمار نمیرود. این مدل بر پایه Qwen3-4B ساخته شده و با مجموعهداده OpenCodeReasoning شرکت NVIDIA آموزش دیده است. با کوانتایز Q4_K_M تنها ۲.۳۸ گیگابایت حجم دارد و کوچکترین فایل این چیدمان محسوب میشود.
کاربرد آن ساده است: کمک به ساخت ابزارهای کوچک ردیابی، مانند یک صفحه HTML ساده برای ثبت نتایج آزمایشهای سلامت. آنچه ثبت میشود بخش خصوصی ماجراست و برای ساخت فرم پایه باید آن را برای مدل توصیف کرد؛ همین موضوع دلیل نگهداشتن این ابزارها بهصورت محلی است. این مدل همچنین کارهای حساسنوازانهای مانند پاکسازی فراداده YAML در یادداشتهای Obsidian و نوشتن الگوهای عبارات باقاعده (Regex) برای استخراج تاریخ از یادداشتها را انجام میدهد.
بهعنوان یک مدل گفتوگوی عمومی چندان کارآمد نیست و چون یک تنظیم دقیق جامعهمحور بدون بنچمارک منتشرشده است، بهتر است تنها کارهای تکفایلی و قابل بازبینی به آن سپرده شود.
جمعبندی؛ ارتقای سختافزار همیشه پاسخ نیست
اگر فردا کسی یک کارت گرافیک ۱۶ گیگابایتی رایگان در اختیار کاربر بگذارد، بیشک آن را میپذیرد. اما رویکرد منطقیتر آن است که از داشتهها تا زمان غیرقابل استفاده شدن بهره گرفته شود؛ بهویژه وقتی هیچ ایراد کارکردی در رایانه وجود ندارد. این به معنای تن دادن به جریانهای کاری هوش مصنوعی خصوصی و ضعیف نیست؛ کافی است مجموعهای درست از مدلهای کوچک متناسب با نیازها ساخته و بهینهسازی شود.