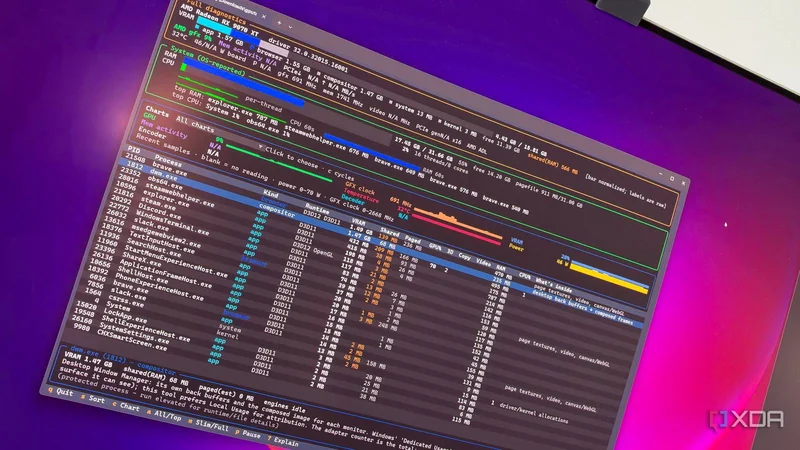
در سالهای اخیر، حافظه ویدئویی (VRAM) برای اجرای بازیهای با رزولوشن بالا و مدلهای هوش مصنوعی محلی به کالایی ارزشمند تبدیل شده است. مدیریت وظایف (Task Manager) ویندوز سالهاست مقدار مصرف VRAM را نمایش میدهد، اما تنها چند عدد کلی ارائه میکند و مشخص نمیکند هر برنامه یا پردازش دقیقاً چه بخشی از این حافظه را اشغال کرده است. همین شکاف، دلیل ساخت ابزاری به نام gputaskman است؛ برنامهای رایگان و متنباز که اسکات هانسلمن، معاون مایکروسافت، آن را در GitHub منتشر کرده و در ترمینال اجرا میشود.
مدیریت وظایف مقدار را میگوید، نه جزئیات را
تب Performance در مدیریت وظایف، حافظه اختصاصی و اشتراکی GPU را برای کل کارت نمودار میکند و اگر ستون Dedicated GPU memory را در تب Details اضافه کنید، عددی برای هر پردازش نیز میبینید. با این حال، این اعداد نشان نمیدهند که هر پردازش با آن حافظه چه میکند. gputaskman در ویندوز از همان خانواده شمارندههای گرافیکی (graphics counters) میخواند، بنابراین مجموع ارقام آن با مدیریت وظایف همخوانی نزدیکی دارد، اما تصویر بسیار روشنتری از مصرف حافظه ارائه میدهد.
دستهبندی پردازشها و نوار مصرف تجمعی
gputaskman هر پردازش را در یک دسته قرار میدهد و برچسبگذاری میکند: مدل زبانی بزرگ (LLM)، ترکیبکننده (compositor)، مرورگر (browser)، برنامه (app) یا سیستم (system). این ابزار همچنین مشخص میکند هر پردازش از کدام runtime گرافیکی استفاده میکند و در صورت امکان، توضیح کوتاهی درباره محتوای احتمالی حافظه آن ارائه میدهد.
- نمایش سهم هر پردازش از حافظه ویدئویی بهصورت تفکیکشده
- برچسبگذاری نوع پردازش و runtime گرافیکی مورد استفاده
- ارائه توضیح کوتاه درباره محتوای احتمالی حافظه هر پردازش
- نمایش نوار پشتهای (stacked bar) در پنل دستگاه (device panel) برای مشاهده سهم مدل و سایر برنامهها در یک نگاه
در عمل چه چیزی VRAM را اشغال کرده بود؟
نویسنده مقاله پس از بارگذاری مدل Qwen3-8B مشاهده کرده که 7.37 گیگابایت از 15.81 گیگابایت حافظه کارت RX 9070 XT در حال استفاده بوده و بیش از 4 گیگابایت از این مقدار ارتباطی با مدل نداشته است. ترکیبکننده ویندوز، یعنی dwm.exe، حدود 1.37 گیگابایت را برای بافرهای پسزمینه دسکتاپ و سطوح ترکیبکننده (compositor surfaces) نگه داشته بود؛ موضوعی که با توجه به مانیتور 4K با نرخ 240 هرتز منطقی به نظر میرسد، اما پیش از این به این شکل تفکیک نشده بود.
مرورگر Brave حدود 1.14 گیگابایت برای مواردی مانند بافتهای صفحه (page textures)، ویدئو و canvas استفاده میکرد. OBS که بافر بازپخش کلیپهای بازی را مدیریت میکند، 445 مگابایت و کمککننده وب Steam حدود 298 مگابایت حافظه گرفته بودند. مجموعهای از برنامههای دیگر مانند Discord، Slack و حتی File Explorer نیز هر یک حدود صد مگابایت اشغال کرده بودند. روی یک کارت 16 گیگابایتی، این یعنی حدود یکچهارم ظرفیت VRAM پیش از آنکه مدل کاری انجام دهد، از دست رفته است.
بازرس مدل؛ مهمترین دلیل امتحان کردن ابزار
اگر llama-server را در فهرست پردازشها انتخاب کنید، gputaskman جزئیات بیشتری فراتر از نوع پردازش و میزان مصرف ارائه میدهد. این ابزار مدل، معماری، تعداد پارامترها، کوانتیزهسازی (quantization) و زمینه آموزش (training context) را شناسایی میکند و تخصیص حافظه را نیز تفکیک میکند: 4.35 گیگابایت برای وزنها (weights)، 576 مگابایت برای حافظه نهان KV (KV cache) و 108 مگابایت برای بافرهای محاسباتی (compute buffers). این اعداد مستقیماً از لاگهای llama.cpp خوانده میشوند.
مقدار حافظه نهان KV توضیح میدهد که چرا یک مدل میتواند فضای بیشتری از VRAM را نسبت به حجم فایل خود اشغال کند. gputaskman این موضوع را با نمایش هزینه هر توکن (cost per token) روشن میکند: 144 کیلوبایت در دقت پیشفرض f16 برای این مدل، و سپس محاسبه میکند که این مقدار در زمینه 4K به 576 مگابایت و در زمینه 32K به 4.5 گیگابایت میرسد. llama.cpp این حافظه را هنگام بارگذاری مدل رزرو میکند. بدون فایل لاگ، ارقام مربوط به KV تخمینی و بر اساس فراداده (metadata) فایل مدل هستند. gputaskman همچنین Ollama، LM Studio، vLLM و Foundry Local را بهصورت آماده میشناسد، هرچند README ابزار صریحاً میگوید برخی از این مسیرها کمتر از llama.cpp در دنیای واقعی آزمایش شدهاند.
وضعیت آزمایشی و محدودیتها
بر اساس README و تاریخچه GitHub، این نرمافزار هنوز در حال توسعه است. مواردی مانند شمارندههای دستگاه و پردازش، اندازهگیری واقعی هستند، اما برچسبهای بار کاری (workload labels) و تفکیک مدل تخمینیاند و ممکن است اشتباه باشند. کاربران کارتهای AMD در ویندوز، مانند نویسنده مقاله، جزئیات کمتری نسبت به کاربران Nvidia میبینند. روی RX 9070 XT، فعالیت حافظه، ترافیک PCIe و فرکانس ویدئو بهصورت N/A نمایش داده میشوند، زیرا gputaskman در این بخش به کتابخانه درایور AMD متکی است و نه به تلهمتری (telemetry) غنیتری که کارتهای Nvidia ارائه میدهند.
جمعبندی
gputaskman تقریباً روی همه سیستمعاملها اجرا میشود و مستقیماً در ترمینال کار میکند؛ بنابراین ردپای منابع (footprint) بسیار کمی دارد. برای کسانی که مدلهای محلی را در هر ظرفیتی اجرا میکنند، این ابزار در مقایسه با مدیریت وظایف ویندوز یک انتخاب ضروری برای علاقهمندان هوش مصنوعی محلی است.