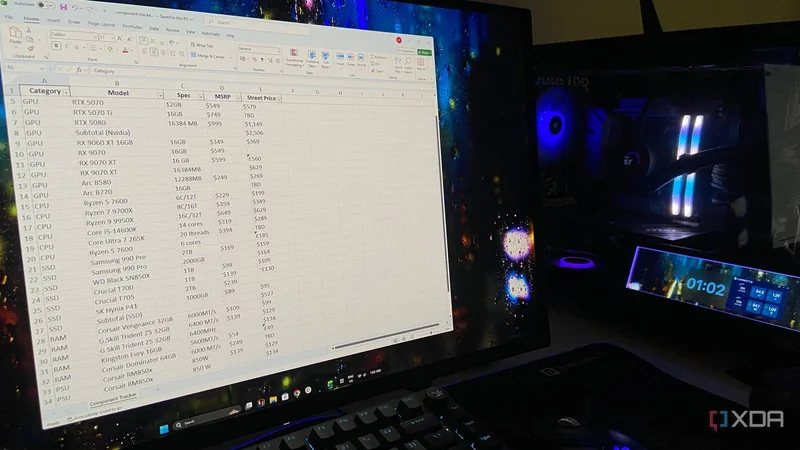
وبسایت XDA Developers در آزمایشی، چهار مدل زبانی کوچک و محلی (Local LLMs) را با یک صفحهگسترده (Spreadsheet) عمداً آشفته روبهرو کرد تا میزان اتکاپذیری آنها در تحلیل دادههای واقعی سنجیده شود. این فایل CSV شامل قیمتهای ناقص، واحدهای ذخیرهسازی متفاوت، ارزهای گوناگون و ردیفهای جمعجزئی بود.
روش آزمون
هر چهار مدل روی llama.cpp و با کوانتیزهسازی Q4_K_M، پنجره زمینه (Context Window) ۱۶K و بارگذاری کامل روی GPU اجرا شدند. سختافزار آزمون شامل RTX 4070 Ti Super 16GB، پردازنده Ryzen 5 7600X و ۳۲ گیگابایت حافظه DDR5-6000 بود. ابزارها، جستوجوی وب و حالت استدلال خاموش شد و هر پرسش در چت تازه و با پیوست همان CSV مطرح شد.
شش پرسش طراحی شد؛ چهار پرسش پاسخ درست در فایل داشت و دو پرسش درباره دادهای بود که در صفحهگسترده وجود نداشت: میانگین قیمت GPU در سهماهه دوم ۲۰۲۲ و تاریخ عرضه RTX 5070 Ti. مدلها باید در برابر این دو پرسش، امتناع تمیز نشان میدادند.
نتایج کلی مدلها
- Gemma 4 E4B: بهترین عملکرد با ۱۲ از ۱۸ امتیاز؛ در تشخیص ارزانترین SSD یکترابایتی درست عمل کرد و در پرسشهای داده غایب نیز پاسخ جعلی نساخت.
- Phi-4 Mini: ۸ از ۱۲ امتیاز؛ در محاسبه میانگین GPU دو پاسخ کاملاً متفاوت و نادرست داد و قیمتهای MSRP را با قیمت خیابانی ترکیب کرد.
- Ministral 3 3B: ۶ از ۱۲ امتیاز؛ ردیفهای درست را انتخاب کرد اما در جمعزدن آنها ناکام ماند و محصولات قیمتگذاریشده به پوند را بهعنوان ارزانترین گزینه معرفی کرد.
- Ministral 3 8B: ۶ از ۱۲ امتیاز؛ بزرگترین مدل آزمون بود اما در پرسش داده غایب، میانگین «فرضی» ۵۷۵ دلاری ساخت و در اجرای دوم نیز تاریخچه قیمت جعلی برای RTX 30 ارائه داد.
خطای مشترک: ارزانترین کارت ۱۶ گیگابایتی
در تمام اجراها، هیچ مدلی کارت RX 9060 XT 16GB با قیمت ۳۶۹ دلار را بهعنوان ارزانترین کارت ۱۶ گیگابایتی شناسایی نکرد. همه مدلها بهجای آن RTX 5060 Ti را با قیمت MSRP یا قیمت پوندی بازگرداندند؛ در حالی که پاسخ درست در همان ستون قرار داشت.
جمعبندی
پس از نرمالسازی امتیازها، Gemma 4 E4B و Phi-4 Mini هر دو به ۶۷ درصد رسیدند و در پرسشهای دادهای، سه مدل از چهار مدل دقیقاً ۵۰ درصد امتیاز گرفتند. تفاوت اصلی در آن بود که کدام مدل هنگام ناتوانی صفحهگسترده از پاسخدادن، امتناع میکرد. نویسنده تأکید میکند این آزمون محدود به چهار مدل، یک کوانتیزهسازی و یک فایل پر از تله بوده است؛ با این حال نتیجه نشان میدهد خروجی مدلهای کوچک محلی در چنین دادههایی باید پیش از اتکا، بازبینی انسانی شود.