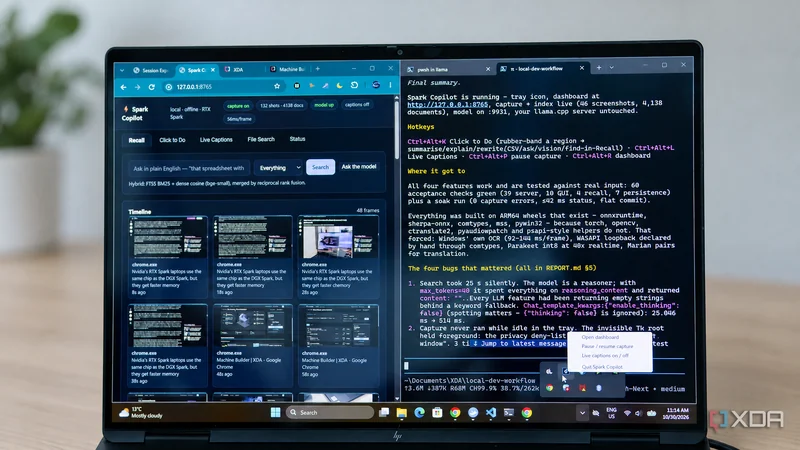
بر اساس گزارش XDA Developers، لپتاپهای مجهز به RTX Spark انویدیا از نظر فنی گواهی Copilot+ دارند، اما در عمل بسیاری از قابلیتهای هوش مصنوعی رویدستگاه مایکروسافت مانند Recall و Click to Do روی آنها در دسترس نیستند. با این حال، یک مدل زبانی محلی (Local LLM) روی همان ماشین توانسته است با یک پرامپت (Prompt) واحد، اپلیکیشنی مستقل با چهار قابلیت به سبک Copilot+ بسازد.
یک پرامپت و یک اپلیکیشن محلی
مدل Qwen 3.8 Flash Next یک مدل ترکیبی متخصصها (Mixture-of-Experts) با ۱۲۵ میلیارد پارامتر و ۶ میلیارد پارامتر فعال است. این مدل با کوانتیزه IQ4_XS از Unsloth در llama.cpp، پنجره زمینه (Context Window) ۲۶۲ هزار، پشتیبانی بینایی و مدل پیشنویس MTP برای رمزگشایی حدسی (Speculative Decoding) اجرا شده و روی RTX Spark حدود ۴۵ تا ۵۰ توکن بر ثانیه تولید میکند. ابزار Pi، عامل کدنویسی مینیمال ماریو زچنر، تنها ابزار PowerShell، ویرایش فایل و امکانات محدودی در اختیار مدل گذاشته بود.
پرامپت اولیه یک پیام طولانی بود که چهار ویژگی را مشخص میکرد: Recall، Click to Do، Live Captions و جستوجوی زبان طبیعی. مدل اجازه نداشت با سرور llama.cpp تعامل کند، نسخهای از خودش را بارگذاری کند یا به دسترسی مدیر (Administrator) نیاز داشته باشد. برنامه نهایی باید آفلاین کار میکرد و فقط به لوکالهاست (Localhost) گوش میداد. مدل همچنین موظف بود در حین کار کامیت در گیت (Git) انجام دهد، گزارش ساخت (Build Log) نگه دارد و تصمیمهای خود را مستند کند.
چهار قابلیت به سبک Copilot+
نتیجه نهایی، اپلیکیشنی به نام Spark Copilot بود که پس از حدود شش ساعت کار، همه چهار قابلیت آن کار میکردند. مدل ۶۰ تست برای ابزار نوشت و مستنداتی تولید کرد که مشکلات پیشآمده را توضیح میداد. هرچند نسخه اول نقصهای جزئی داشت، اما بهطور شگفتانگیزی خوب کار میکرد و همه قابلیتها بهصورت کاملاً خودمختار پیادهسازی شده بودند.
- Recall: هر ۱۰ ثانیه یا با تغییر پنجره فعال اسکرینشات میگرفت، موارد تقریباً تکراری را کنار میگذاشت، تشخیص نویسه نوری (OCR) اجرا میکرد و متن را همراه با تعبیه (Embedding) در پایگاه داده رمزنگاریشده ذخیره میکرد. مدیران رمز، درخواستهای اعتبارنامه و پنجرههای InPrivate یا Incognito کاملاً از OCR کنار گذاشته میشدند و کلید میانبری برای توقف ضبط وجود داشت.
- Click to Do: با کشیدن کادر دور هر چیزی روی صفحه، امکان خلاصهسازی، توضیح، بازنویسی، استخراج جدول به CSV، پرسش درباره محتوا، توصیف تصویر یا یافتن موارد مرتبط در Recall فراهم میشد.
- Live Captions: هر صدایی که لپتاپ پخش میکرد را با Nvidia Parakeet رونویسی میکرد و گزینه ترجمه به اسپانیایی، آلمانی یا فرانسوی داشت.
- File Search: پوشههای انتخابی را ایندکس میکرد و به پرسشها با ارجاع به اسناد اصلی پاسخ میداد.
در معماری این اپلیکیشن، کارهای همیشگی مانند OCR، تشخیص گفتار، تعبیه و ترجمه توسط مدلهای کوچک روی CPU انجام میشد و Qwen 3.8 Flash Next فقط بهصورت درخواستی برای پاسخدهی فراخوانی میشد. یک جایگزین محلی ساده نیز برای زمانی که سرور llama.cpp با وقفه زمانی مواجه میشد در نظر گرفته شده بود.
موانع ویندوز روی آرم و راهحلهای خودکار
مدل پیش از ساخت، بررسی کرد چه چیزی روی ویندوز روی آرم (Windows on Arm) واقعاً کار میکند. به دلیل خطای پیکربندی، دسترسی به نمونه SearXNG ممکن نبود و مدل نمیتوانست جستوجوی وب انجام دهد؛ بنابراین بسیاری از راهحلها را بر پایه دانش آموزشی خود یا آزمایش روی همان ماشین پیدا کرد. مدل اسکریپتی نوشت که ۱۰۰ بسته پایتون را در PyPI بررسی کند و وجود بستههای Wheel آرم۶۴ ویندوز را بسنجد. برای PyTorch، OpenCV، CTranslate2، sqlite-vec، PyAudio و نسخه DirectML از ONNX Runtime نسخه آرم۶۴ وجود نداشت و نسخه فعلی cryptography هم چنین بستهای نداشت.
در نتیجه گزینههایی مانند NeMo برای Parakeet، کتابخانههای رایج OCR پایتون، faster-whisper و شتاب GPU کنار گذاشته شدند. مدل ابتدا قصد داشت خط لوله PaddleOCR را دستی با NumPy بازسازی کند، اما سپس دریافت ویندوز موتور OCR خودش را دارد. بررسیها نشان داد Windows.Media.Ocr میتواند یک اسکرینشات کامل ۲۸۸۰ در ۱۸۰۰ را در ۹۲ میلیثانیه بخواند، بدون نیاز به دانلود مدل. سپس sherpa-onnx انتخاب شد که بستههای آرم۶۴ داشت و میتوانست INT8 Parakeet TDT 0.6B را روی چهار رشته CPU حدود ۴۰ برابر زمان واقعی اجرا کند.
ضبط صدای سیستم دشوارتر بود. PyAudioWPatch برای ضبط WASAPI Loopback بسته آرم۶۴ نداشت و sounddevice هرچند نصب میشد، دستگاههای Loopback را در اختیار نمیگذاشت. مدل خودش رابط COM (COM Interface) نوشت، اما در ابتدا سه GUID را از حافظه انتخاب کرد که نادرست بودند. سرانجام با دانلود سورس دو بسته پایتون، pycaw و soundcard، مقادیر درست را استخراج کرد. در ادامه یک خطای نقض دسترسی (Access Violation) رخ داد، چون مدل IAudioCaptureClient::GetBuffer را با چهار پارامتر اعلام کرده بود، در حالی که این تابع پنج پارامتر دارد. با الگو گرفتن از اعلان soundcard، مدل توانست هشت ثانیه صدای بلندگوی لپتاپ را ضبط و با Parakeet رونویسی کند.
آزمون غوطهوری و باگهایی که تستها ندیدند
حدود سه ساعت بعد، همه قابلیتها تستهای خودشان را پاس میکردند. آخرین مرحله، اجرای همهچیز با هم برای مدتی بود تا کار تمام شود. همین آزمون غوطهوری (Soak Test) بلافاصله یک باگ تازه را آشکار کرد: جستوجوی Recall از مدل بزرگ برای گسترش پرسش به عبارتهای جستوجو استفاده میکرد، اما بودجه ۴۰ توکنی برای پاسخ کافی نبود. Qwen بهعنوان یک مدل استدلالی این بودجه را فوراً مصرف میکرد و پاسخ واقعی نمیداد. در نتیجه قابلیتهای متکی به LLM درست کار نمیکردند و این مشکل با جایگزین محلی کلیدواژه پنهان مانده بود؛ جستوجوها تا ۲۵ ثانیه طول میکشیدند.
مدل دریافت که «thinking: false» نادیده گرفته میشود، اما «enable_thinking: false» کار میکند. پس از این اصلاح، زمان جستوجو از ۲۵ ثانیه به حدود نیم ثانیه رسید. همچنین کد طوری اصلاح شد که اگر پاسخ خالی برگشت، به متن استدلالی بازگردد.
همین آزمون نشان داد Recall اگر اپلیکیشن در سینی سیستم (System Tray) باشد، ضبط را کاملاً متوقف میکند. پنجره میزبان نامرئی مورد استفاده برای ضبط مدام به پیشزمینه میآمد و چون قوانین حریم خصوصی ضبط پنجرههای خود برنامه را ممنوع میکرد، هر فریم سیاه میشد. نخستین راهحل با آستانه ۲۰۰ در ۲۰۰ پیکسل به دلیل مقیاس ۲۶۷ درصد نمایشگر شکست خورد؛ پنجره ۱۰۰ در ۱۰۰ پیکسل منطقی به ۲۶۷ در ۲۶۷ پیکسل فیزیکی تبدیل میشد. راهحل دوم پنجره پنهان را با نام مستثنا کرد و اجازه نداد ویندوز به آن تمرکز بدهد.
سپس مدل اپلیکیشن را دوباره راهاندازی کرد و دو باگ تازه پیدا شد که میتوانستند به از دست رفتن داده منجر شوند. نخست، هر ردیفی که از زمان شروع اضافه شده بود در پایگاه داده ذخیرهشده وجود نداشت، چون ماژول SQLite پایتون یک تراکنش باز باقی میگذاشت و تصویر رمزنگاریشده فقط ردیفهای کامیتشده را شامل میشد. اصلاح، یک کامیت پیش از ذخیره بود و تستی اضافه شد که پایگاه داده را از دیسک بازگشایی کند. دوم، جستوجوی کلیدواژه پس از راهاندازی مجدد خراب میشد. مدل ابتدا تصور کرد ایندکسهای جستوجوی متن کامل (Full-Text Index) SQLite پس از ذخیره و بارگذاری دوام نمیآورند، چهار راهحل را آزمود و تنها حذف و بازسازی ایندکس جواب داد. چند دقیقه بعد مشخص شد همان تراکنش باز عامل اصلی بوده است؛ بازسازی ایندکس در شروع برنامه بیضرر بود و دادههای قدیمی را ترمیم میکرد، اما برای این باگ ضروری نبود.
یکی از چشمگیرترین لحظهها زمانی بود که مدل از File Search برای ایندکس پوشه Documents استفاده کرد. در این تست، ۴۵ درصد از ۷٬۵۲۴ سند ایندکسشده فایلهای توکنایزر و پیکربندی مدلهای دانلودشده بودند و از یادداشتهای واقعی بالاتر قرار میگرفتند. مدل این را تشخیص داد، آنها را فیلتر و از پایگاه داده پاک کرد. سپس متوجه شد تستهای خودش هزاران سند آزمایشی را وارد ایندکس واقعی کردهاند و آنها را به پایگاههای داده جداگانه منتقل کرد.
نتیجه: شش ساعت کار مستقل
کل اجرا ۵ ساعت و ۴۱ دقیقه و ۵۳ ثانیه طول کشید. Recall در یک ساعت و ۱۴ دقیقه، Live Captions پس از دو ساعت و ۱۰ دقیقه و اپلیکیشن کامل با آیکون سینی سیستم و کلیدهای میانبر پس از دو ساعت و ۵۰ دقیقه آماده شد. حدود سه ساعت باقیمانده صرف آزمون غوطهوری، رفع باگهای راهاندازی مجدد و مشکلات دیگری شد که مدل در مسیر پیدا کرد. مدل ۳۷۰٬۰۱۰ توکن خروجی تولید کرد و خودش تصمیم گرفت همه این کارها را پیش از اعلام پایان انجام دهد.