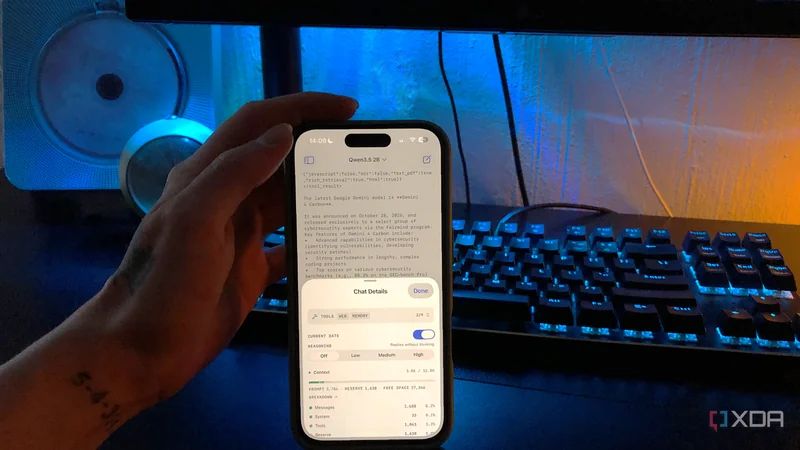
اجرای مدلهای زبانی محلی (Local LLM) روی گوشی چند سالی است ممکن شده، اما بسیاری از کاربران همچنان سراغ ابزارهای هوش مصنوعی ابری میروند؛ چون تصور میکنند فقط مدلهای بزرگ روی سرورهای ابری میتوانند پاسخهای دقیق و عمیق بدهند. تجربه تازه نشان میدهد برای بسیاری از پرسشهای روزمره، یک مدل کوچک محلی که به جستجوی وب (Web Search) مجهز باشد، میتواند کافی و حتی کمهزینهتر باشد.
چرا هوش مصنوعی ابری روی موبایل برای پرسشهای کوچک سنگین است
پرپلکسیتی (Perplexity) یکی از گزینههای آشنا برای جستجوی هوشمند است و مشکل اصلی معمولاً کیفیت پاسخهای آن نیست؛ پاسخها اغلب به شکل گزارشهای مرتب با تیتر و منبع برمیگردند. اما همین ساختار نشان میدهد این اپلیکیشن برای پرسشهای کوتاه و سریع، مانند بررسی تاریخ انتشار یک محصول، طراحی نشده است. نسخه رایگان آن جستجوهای پایه نامحدود دارد و جستجوی حرفهای (Pro Search) تقریباً به پنج بار در روز محدود میشود.
مسئله دیگر هزینه اشتراک است. نویسنده مقاله همزمان برای ChatGPT، Gemini و Claude پول میدهد و حاضر نیست برای جستجوهای سریع، اشتراک چهارم را اضافه کند. از سوی دیگر، پرپلکسیتی در فوریه ۲۰۲۶ برنامه تبلیغاتی خود را کنار گذاشت و در همان ماه ChatGPT نمایش تبلیغ در نسخههای رایگان و ارزانتر را آغاز کرد. افزون بر این، پرپلکسیتی اکنون یکپارچهسازی خرید و جستجوی سازمانی را نیز در کنار اشتراکها میفروشد. حریم خصوصی هم دلیل مهمی برای رفتن به سمت اجرای محلی (Local) است، هرچند تنها دلیل نیست.
ترکیب مدل محلی و جستجوی وب چگونه کار میکند
برای این کار به دو چیز نیاز است: یک اپلیکیشن مدل زبانی محلی که قابلیت جستجوی وب داشته باشد، و مدلی که در فراخوانی ابزار (Tool Calling) عملکرد قابل قبولی نشان دهد. مدل محلی بهتنهایی نمیتواند در وب بگردد؛ اپلیکیشن یک ابزار جستجو در اختیار آن میگذارد و مدل باید تشخیص دهد چه زمانی پرسش به جستجو نیاز دارد و ابزار را درست فراخوانی کند. مدلهای بسیار کوچک در این بخش ضعیف عمل میکنند.
در بنچمارک Berkeley Function Calling Leaderboard، مدل Qwen 3.5 0.8B امتیاز ۲۵.۳ درصد و Qwen 3.5 2B امتیاز ۴۳.۶ درصد گرفته است. به همین دلیل، نسخههای ۲ میلیارد پارامتری (2B) را باید حداقل قابل قبول برای این روش در نظر گرفت.
اپلیکیشنهای پیشنهادی برای اجرای محلی
- Noema: انتخاب اصلی نویسنده مقاله، اما فقط برای iOS در دسترس است. جستجوی وب آن از پنج نتیجه نخست Brave استفاده میکند و هنگام بارگذاری مدل بررسی میکند آیا مدل از فراخوانی ابزار پشتیبانی میکند یا نه.
- Off Grid: گزینه پیشنهادی برای اندروید که جستجوی وب آن پنج نتیجه برتر Brave را استخراج میکند.
- LLM Hub: برای اندروید و iOS عرضه شده و جستجوی وب در چت آن تعبیه شده است؛ گزینهای مناسب برای کاربران آیفون که Noema را نمیپسندند.
- Local LLM: اپلیکیشنی برای اندروید که مدلهای Gemma 4 میتوانند پس از تأیید کاربر در وب جستجو کنند. Gemma 4 با نسخههای E2B و E4B احتمالاً بهترین جایگزین Qwen است و روی گوشیهای ۶ و ۸ گیگابایت رم اجرا میشود.
تجربه استفاده: Qwen 3.5 2B با کوانتیزهسازی Q4_K_M در Noema
ترکیبی که نویسنده مقاله استفاده میکند، Qwen 3.5 2B با کوانتیزهسازی (Quantization) Q4_K_M در Noema روی یک آیفون ۱۶ پایه است. جستجوی وب یک کلید روشن و خاموش در منوی ابزارهاست و جستجوها از طریق Noema Search انجام میشود؛ یک نمونه SearXNG که به حساب کاربری نیاز ندارد و شناسهای به پرسشها متصل نمیکند.
دلیل عملکرد خوب این تنظیمات روی موبایل این است که کل صفحات وب به مدل داده نمیشوند. Noema فقط بخشهای مرتبط با پرسش را استخراج میکند و جاوااسکریپت صفحه و تصاویر اسکنشده را نادیده میگیرد؛ بنابراین مدل تنها قطعههای کوتاهی از متن را میخواند. پاسخهایی که از جستجوی وب استفاده کردهاند، یک پنل شواهد (Evidence panel) هم دارند که فهرستی بازشو از منابع است. کاربر میتواند منابع را لمس کند تا در مرورگر اصلی گوشی باز شوند و بررسی بیشتری انجام دهد.
Noema ابزارهای متعددی دارد که برای هر نشست قابل فعالسازی هستند. نویسنده مقاله کنار Web Search، ابزار Current Date را نیز روشن نگه میدارد؛ چون مدلی که تاریخ پایان آموزش آن قدیمی است، بدون دانستن تاریخ امروز نمیتواند پرسشهای مربوط به «آخرین» رویدادها را درست بفهمد. برای Qwen 2B، حالت Reasoning/Thinking خاموش است؛ در غیر این صورت مدل بیش از حد حرف میزند و توکنها را هدر میدهد. پاسخها در این حالت سریع برمیگردند و مدل با حجم حدود ۱.۲۸ گیگابایت، بخش زیادی از ۸ گیگابایت رم گوشی را آزاد میگذارد.
چرا مدل کوچک با جستجوی وب کافی است
اندازه مدل تعیین میکند چه مقدار دانش را میتواند در خود نگه دارد. پژوهشها نشان میدهند حتی با فشردهسازی به ۸ بیت، تقریباً به ازای هر پارامتر حدود ۲ بیت دانش قابل ذخیره است. مدل ۲ میلیارد پارامتری جای زیادی برای حفظ کردن جهان ندارد و هر چه هم آموخته باشد، مانند مدلهای غولپیکر، در تاریخ پایان آموزش متوقف میشود.
اما خواندن وظیفه دیگری است. یک مطالعه بزرگ روی مدلهای کوچک نشان داده است توان استدلال آنها بیش از آنکه تنها به مقیاس وابسته باشد، به نحوه آموزش و کیفیت داده بستگی دارد. وقتی جستجو روشن است، مدل چند قطعه متن را میخواند و آنچه را خوانده گزارش میکند و لازم نیست خودش چیز زیادی را به خاطر بسپارد. به همین دلیل نویسنده مقاله از نسخه چهار بیتی (4-bit Quant) راضی است؛ همان مطالعه نشان داده کوانتیزهسازی استدلال را حفظ میکند و مدلهای ۴ بیتی هنوز سیگنال دانش را با اطمینان کمتری نگه میدارند، در حالی که در ۲ بیت ممکن است فروپاشی آغاز شود. اطلاعاتی که نسخههای کمدقتتر از دست میدهند، با جستجو جبران میشوند.
ابر همچنان برای پرسشهای پیچیده میماند
برای وظایف چندمرحلهای که به وب نیاز دارند، مدلهای ابری همچنان منطقیاند. آیفون پایه نویسنده مقاله ممکن است با سرعت عرضه مدلهای جدید اپل قدیمی به نظر برسد و طبیعتاً برخی پرسشها را بهتر است به هوش مصنوعی ابری سپرد. با این حال، مدلهای محلی موبایل برای حالت آفلاین (Offline) یا کار با اسناد خصوصی روی گوشی بسیار ارزشمندند. نتیجه تجربه این است که لازم نیست مدلهای بیش از حد بزرگ را به زور روی گوشی اجرا کرد؛ کافی است به مدل کوچک، جستجوی وب داد تا بسیار داناتر به نظر برسد.